多路搜尋樹與 B-Tree
多路搜尋樹與 B-Tree的重點整理。
這篇整理多路搜尋樹、B-Tree 與 B+ Tree 的結構規則和基本操作。節點如何編碼成磁碟 Page、如何快取與恢復,延伸閱讀 Database Internals 閱讀筆記;更新策略與配置變種則見 B-Tree Variants。
M-Way Search
定義
M-way Search Tree(M ≫ 2)重點
-
主要用於 external search:資料量大,節點通常存於外部儲存(如磁碟),存取以 I/O 次數為主。
-
一個節點的 degree 介於 \(0\) 與 \(m\)。
-
若節點的 degree 為 \(m\),則該節點內的 keys 數 為 \((m-1)\)。
-
同一節點內的 keys 以 遞增 排序。
-
search/insert/delete x的時間為 \(O(h)\),其中 \(h\) 是樹高;若結構 skewed,實際效能最壞也取決於 \(h\)。
分隔 Key 與子指標
內部節點有 N 個 Key 時,會形成 N+1 個子樹搜尋區間,完整表示時需要 N+1 個子指標。最右側子指標負責大於最後分隔 Key 的區間;在一般 B-Tree 中,若搜尋值等於節點內的 Key,可以直接在該節點命中。後面的 B+ Tree 範例則另外指定邊界相等時的路由規則。
定理 (高度為 \(h\) 的 \(m\)-way search tree)
-
節點數上界: \(\sum_{i=1}^{h} (m^{i-1}) \,=\, \frac{m^{h}-1}{m-1}\)
-
Key 上界: \(m^{h}-1\)
直觀:每層最多有 \(m^{i-1}\) 個節點;每節點最多含 \((m-1)\) 個鍵,故總鍵數最多為 \((m-1)\cdot\frac{m^{h}-1}{m-1}=m^{h}-1\)。
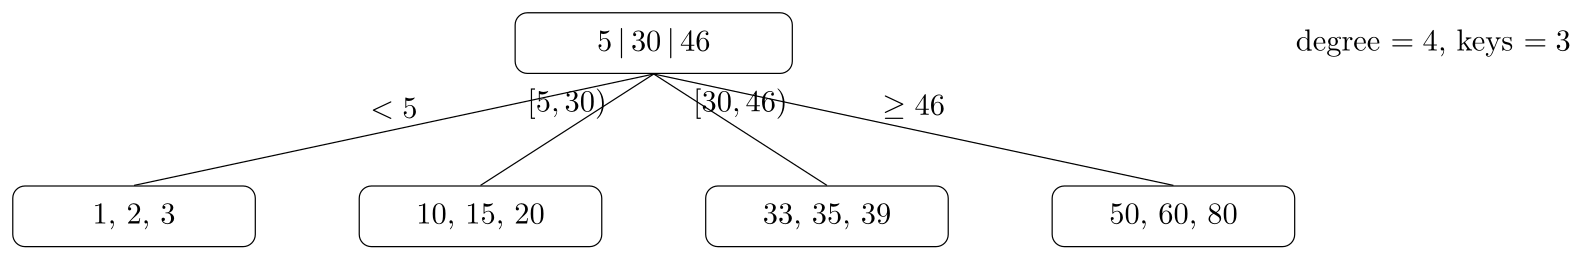
下例:degree = 4,keys = 3;根鍵為 5 | 30 | 46,四個子節點分別承接區間 <5、[5,30)、[30,46)、≥46。
設定
-
root level = 1。
-
每個節點最多 \(m\) 個 children、至多 \((m-1)\) 個 keys。
-
高度 \(h\)(共有 \(h\) 層)。
(A) 最多節點數
第 \(i\) 層(從 1 起算)最多節點數:\(m^{i-1}\).
總節點:
\[\sum_{i=1}^{h} m^{i-1} = 1 + m + m^2 + \cdots + m^{h-1} = \frac{m^{h}-1}{m-1}.\]
(B) 最多鍵數
每節點最多 \((m-1)\) keys,故:
\[\bigg(\frac{m^{h}-1}{m-1}\bigg)\cdot(m-1) = m^{h}-1.\]
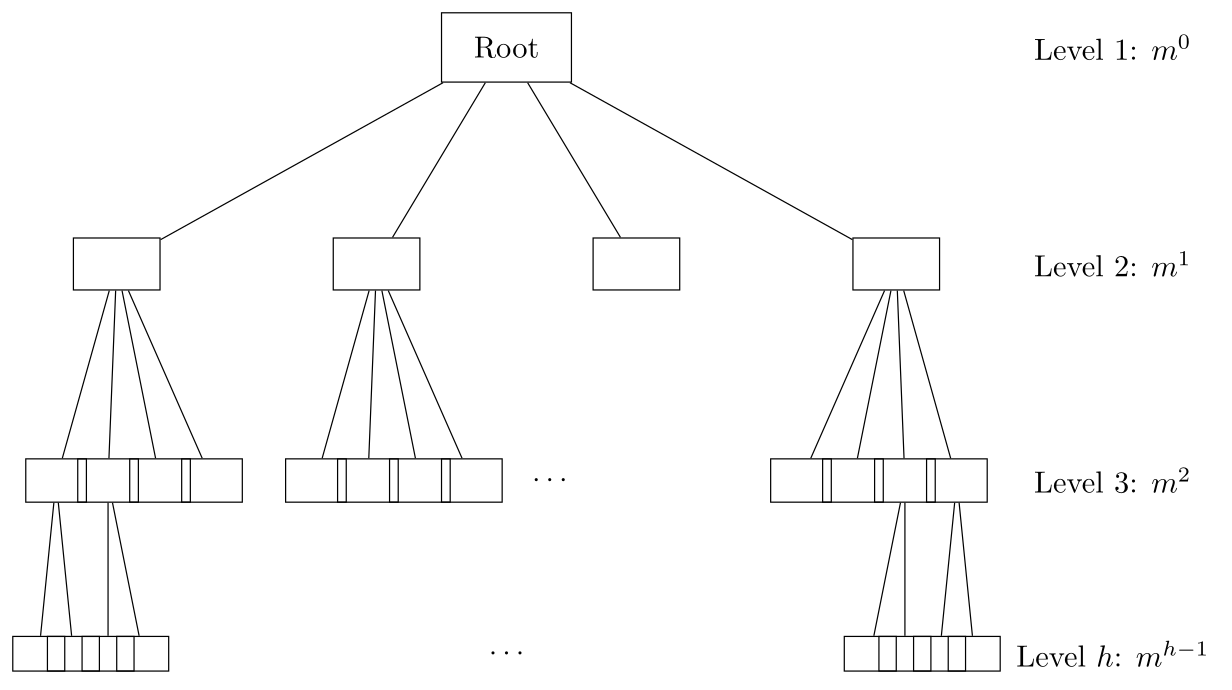
板書對照:右側的兩個 boxed 結果分別是 \(\dfrac{m^{h}-1}{m-1}\)(節點)、\(m^{h}-1\)(keys)。
左側樹形圖:每層的最大節點計數為 \(m^0, m^1, m^2, \dots, m^{h-1}\)。
B Tree of Order M
定義 (Definition)
B-Tree of order m 是一種 balanced m-way search tree,主要應用於外部搜尋 (external search) 與外部排序 (external sort)。若非空,需滿足以下條件:
-
根節點 (root) 的 degree: \(2 \leq \deg(\text{root}) \leq m\)
-
除根以外的內部節點 (internal nodes) 的 degree: \(\left\lceil \tfrac{m}{2} \right\rceil \leq \deg(\text{node}) \leq m\)
-
所有葉節點 (leaf nodes) 必須位於同一層,確保樹保持平衡。
高 Fanout、樹高與 I/O
令 n 為總 Key 數,m 為每個節點的最大子節點數;當各節點保持足夠的占用量時,B-Tree 的高度為 O(logₘ n)。Fanout 越高,同樣資料量通常需要的層數越少;若節點對應磁碟 Page,從 Root 到 Leaf 經過的頁數也較少,因此適合外部搜尋。這裡是在計算節點存取/I/O,節點內尋找 Key 的比較成本仍須另外考慮。精確的最大、最小高度則可由下面的 Key 數上下界推導。
定理 (Theorem)
對於高度為 \(h\) 的 m-way search tree (root level = 1):
-
Maximum number of nodes \(N_{max}=\sum_{i=1}^h m^{i-1} = \frac{m^h - 1}{m - 1}\)
-
Maximum number of keys \(K_{max} = m^h - 1\)
-
Minimum number of nodes \(N_{\min} = 1 + 2 \cdot \frac{\left(\left\lceil \tfrac{m}{2} \right\rceil^{h-1} - 1 \right)}{\left\lceil \tfrac{m}{2} \right\rceil - 1}\)
-
Minimum number of keys \(K_{\min} = 2 \cdot \left\lceil \tfrac{m}{2} \right\rceil^{h-1} - 1\)
-
最少 keys: \(K_{\min}=2\,t^{\,h-1}-1=2\cdot\left\lceil\frac{m}{2}\right\rceil^{h-1}-1\)
- 例如 \(m=3\): \(K_{\min}=2\cdot\left\lceil\tfrac{3}{2}\right\rceil^{h-1}-1=2\cdot 2^{h-1}-1=2^{h}-1\)
-
證明
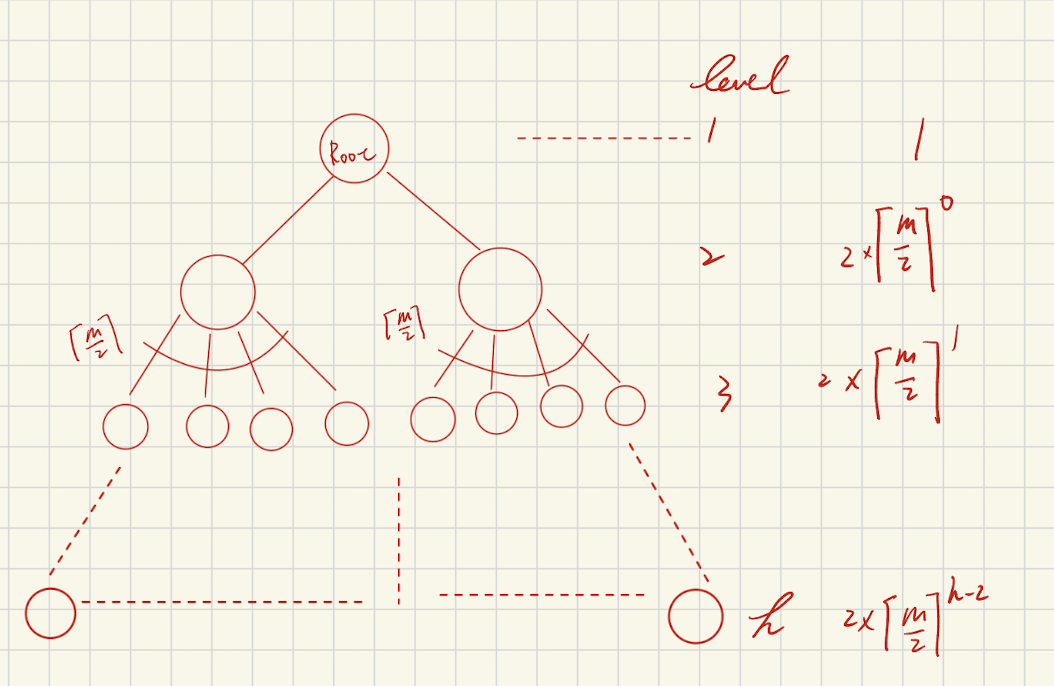
最少 nodes(包含葉)
層別節點數(root 取 degree = 2,其餘皆取 \(\lceil m/2\rceil\)):
因此
最少 keys
-
非根每個節點的最少 keys,簡單來說就是你會需要 3 個 \(key\) 切開 4 個子樹:\(\left\lceil \frac{m}{2} \right\rceil-1\)
-
最少「非根」節點數:\(\Big[\,2\cdot\frac{\left\lceil \tfrac{m}{2} \right\rceil^{\,h-1}-1}{\left\lceil \tfrac{m}{2} \right\rceil-1}\,\Big]\)(由最少 nodes:\(1+2\cdot\dfrac{\left\lceil \tfrac{m}{2} \right\rceil^{h-1}-1}{\left\lceil \tfrac{m}{2} \right\rceil-1}\) 減去 root 得到)
因此最少 keys:
備註
-
名稱「2-3 Tree」、「2-3-4 Tree」等,來自允許的 degree 範圍:
-
Order 3 → degree = 2, 3 → 2-3 Tree
-
Order 4 → degree = 2, 3, 4 → 2-3-4 Tree
-
Order 5 → degree = 3, 4, 5 (root 可為 2), 不是 2-3-4-5 Tree
-
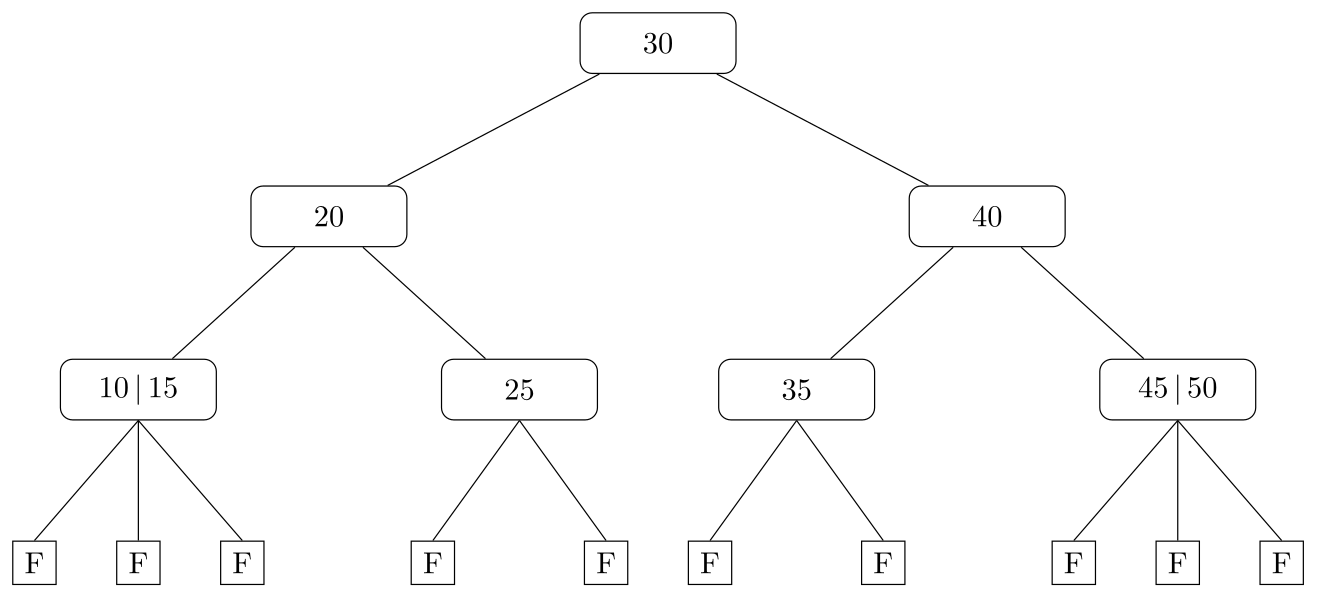
判斷有沒有此種樹
| order mm | 根的 degree | 非根節點 degree | 允許的節點型別(degree) | 常見名稱 | 是否存在 |
|---|---|---|---|---|---|
| 3 | 2–3 | 2–3 | 2, 3 | 2-3 Tree | ✓ |
| 4 | 2–4 | 2–4 | 2, 3, 4 | 2-3-4 Tree | ✓ |
| 5 | 2–5 | 3–5 | 3, 4, 5(根可 2) | order-5 B-Tree 或 3-4-5 Tree | ✗ 對「2-3-4-5」 |
說明:m=5m=5 時,非根下限為 \(\lceil 5/2\rceil=3\)。一般節點 不能 有 degree=2,因此 沒有「2-3-4-5 Tree」 這個名稱。
例:2-3 Tree 給定 key 數 n 求高度界
-
最小高度 (最滿): \(3^{h}-1\ge n\;\Rightarrow\; h=\left\lceil\log_{3}(n+1)\right\rceil\)
-
最大高度 (最稀): \(2^{h}-1\ge n\;\Rightarrow\; h=\left\lceil\log_{2}(n+1)\right\rceil\)
插入 X 到 B 樹 (Order M)
-
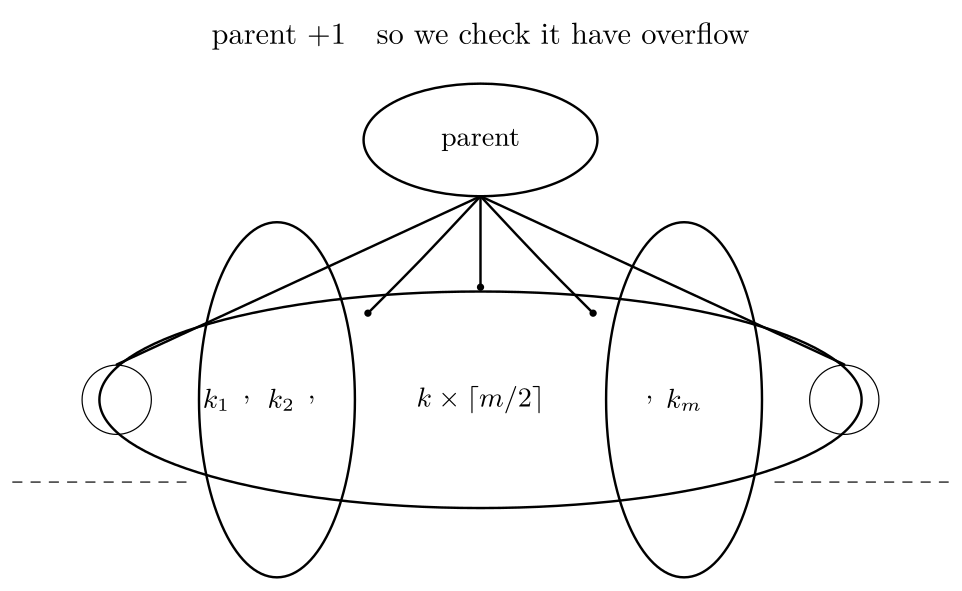
Step 1. Search for X 由於 \(X\) 不在樹中,會找到一個 external node (null)。 將 \(X\) 放入該 external node 的 parent。 (找到 \(X\) 的位置,在 node 放入 \(X\))
-
Step 2. Check the node
-
是否 overflow?key 數 \(= m > m-1\)?
-
如果 沒有 overflow → 結束。
-
如果 overflow → 做 split action,並且往上檢查 parent。
-
-
Split action
-
選出 \(\lceil m/2 \rceil\) 的 key \(k\)
-
把 \(k\) 移到 parent
-
其餘 key 分左右 child
-
Example
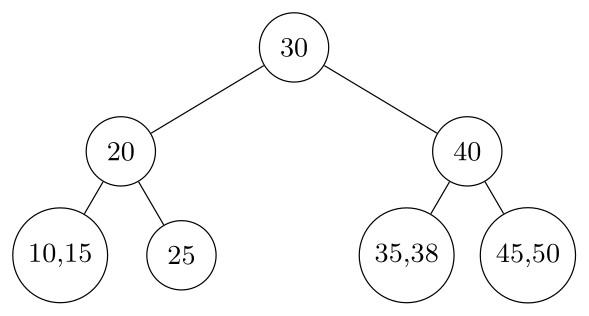
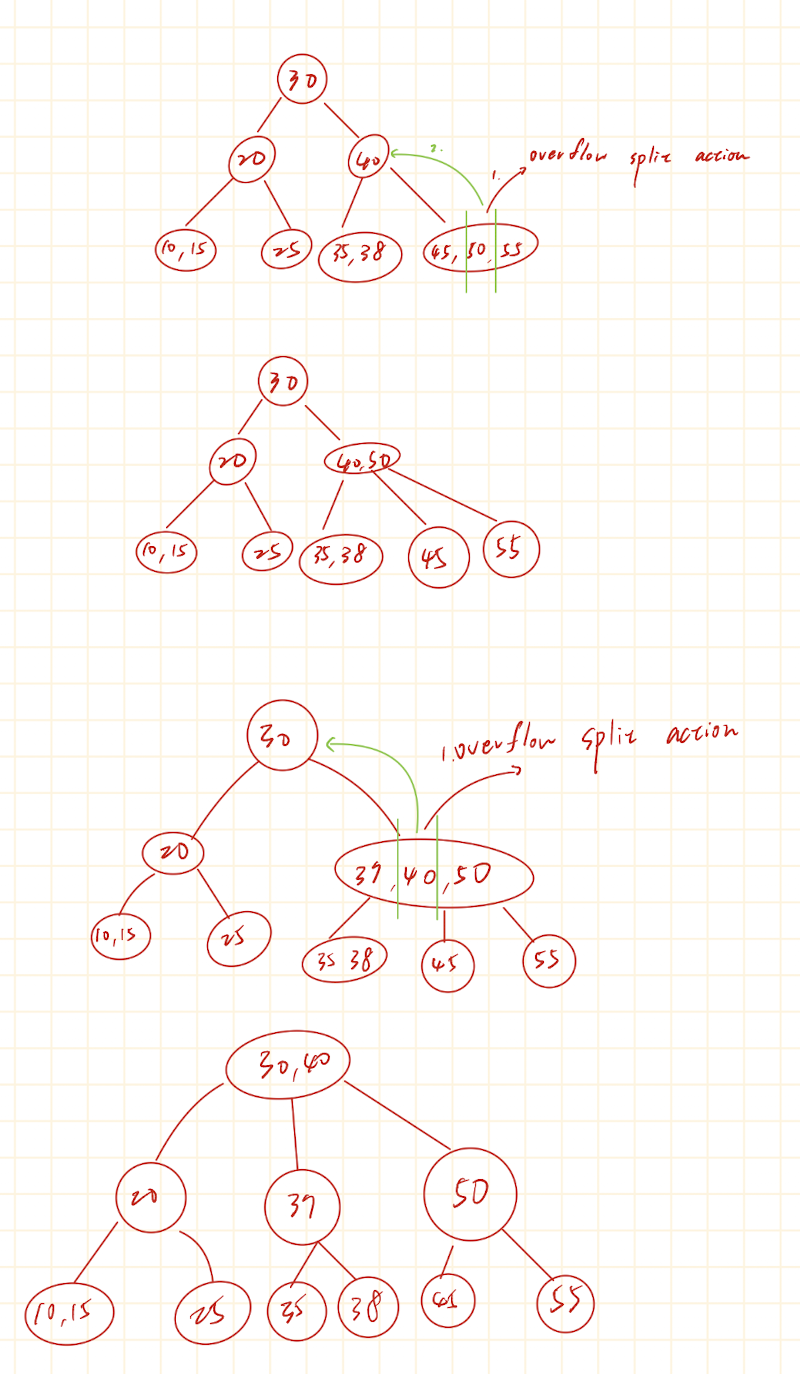
- B tree of order 3 (or 2-3 tree), what’s the result after insert 55, 37
-
插入 55,但是因為 overflow 最多只能 \(\left\lceil \tfrac{m}{2} \right\rceil \leq \deg(\text{node}) \leq m=2\), 所以需要 split action
-
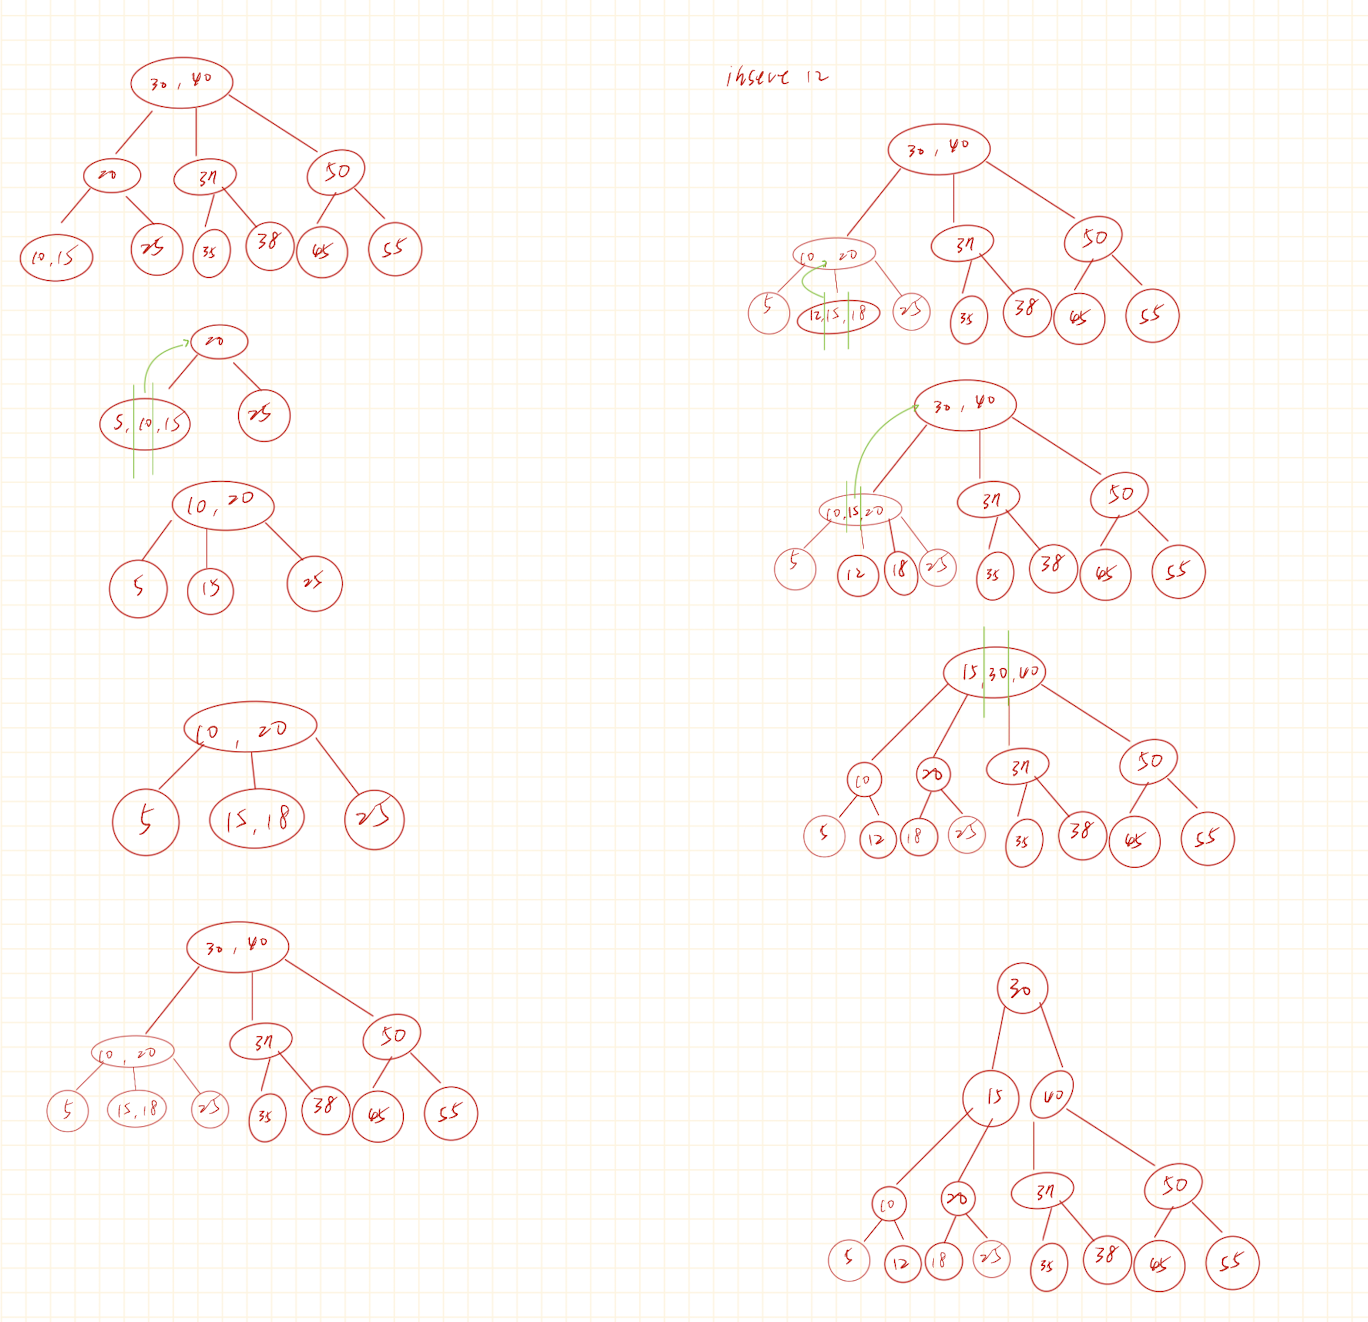
Insert 5,18 and 12 in the 2-3 tree
分裂後如何回到父節點:Breadcrumbs
Breadcrumbs(麵包屑)與 Parent Pointer:Node Split 可能需要往上更新父節點,因此搜尋時可以順便記錄從 Root 往下經過的頁面,以及每一層選擇的 Child Pointer 位置。這份路徑紀錄就是 Breadcrumbs,讓操作在需要時能沿原路向上回溯。
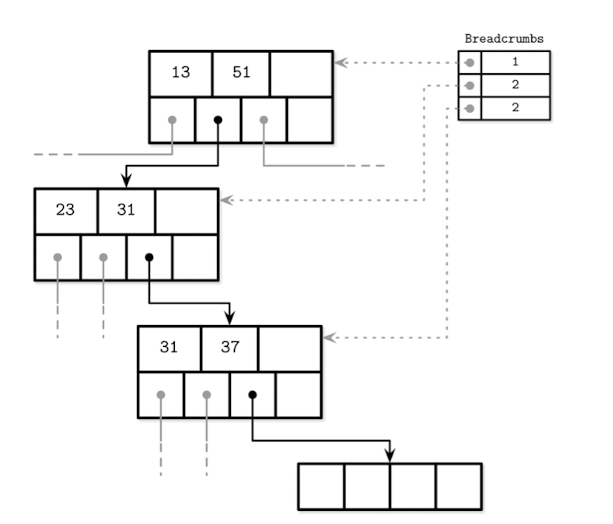
圖中的黑色連線表示往下搜尋的路徑,右側 Breadcrumbs 則記錄各層經過的節點與所選位置。它保存的是「這次從哪裡走下來」,並不是在每個 Child Page 裡永久增加一條指向 Parent 的連結。圖中的 1、2、2 是所選位置的示意,不代表 PostgreSQL 欄位一定使用相同的編號方式。
Parent Node 存在,不代表 Child 必須保存 Parent Pointer。除了 Root 以外,B-Tree 的每個節點都有父節點;父節點原本就透過 Child Pointer(Downlink)指向子節點。往上找 Parent 時,可以使用搜尋過程留下的 Breadcrumbs,不必再從 Child 讀取 Parent Pointer。例如下降路徑為 Root P1、Internal P5、Internal P8,最後到達 Leaf P12;若 P12 發生 Split,就先從 Stack 取得 P8,若父節點也分裂,再回到 P5,必要時一路處理到 Root。
Breadcrumbs 通常是一次操作或 Cursor 在記憶體中的 Traversal State(遍歷狀態),生命週期結束後可以釋放。它與 Buffer Pool/Page Cache 的用途不同:後者快取資料頁內容,Breadcrumbs 則記錄搜尋路徑。Parent Pointer 是另一種向上定位方式,但當子節點因 Split、Merge 或 Rebalancing 換了父節點,就需要維護對應關係。兩者可以並用,卻不是都必須存在;若沒有保留路徑,也沒有 Parent Pointer,仍可從 Root 重新尋找父節點。
實際 DBMS 的路徑 Stack 例子(PostgreSQL BTStack),見 Database Internals。
Delete X in B-Tree of order m
目標:刪除鍵值 xx。先搜尋到包含 xx 的節點 NN。
-
Case I|\(N\) 是 leaf
-
刪除:在 \(N\) 直接移除 \(x\)。t6
-
檢查是否 underflow (鍵數是否太少)。
-
Not underflow:若 \(|N| \ge \lceil m/2\rceil - 1\) → 完成。
-
Underflow:若 \(|N| < \lceil m/2\rceil - 1\) → 進行修復:
-
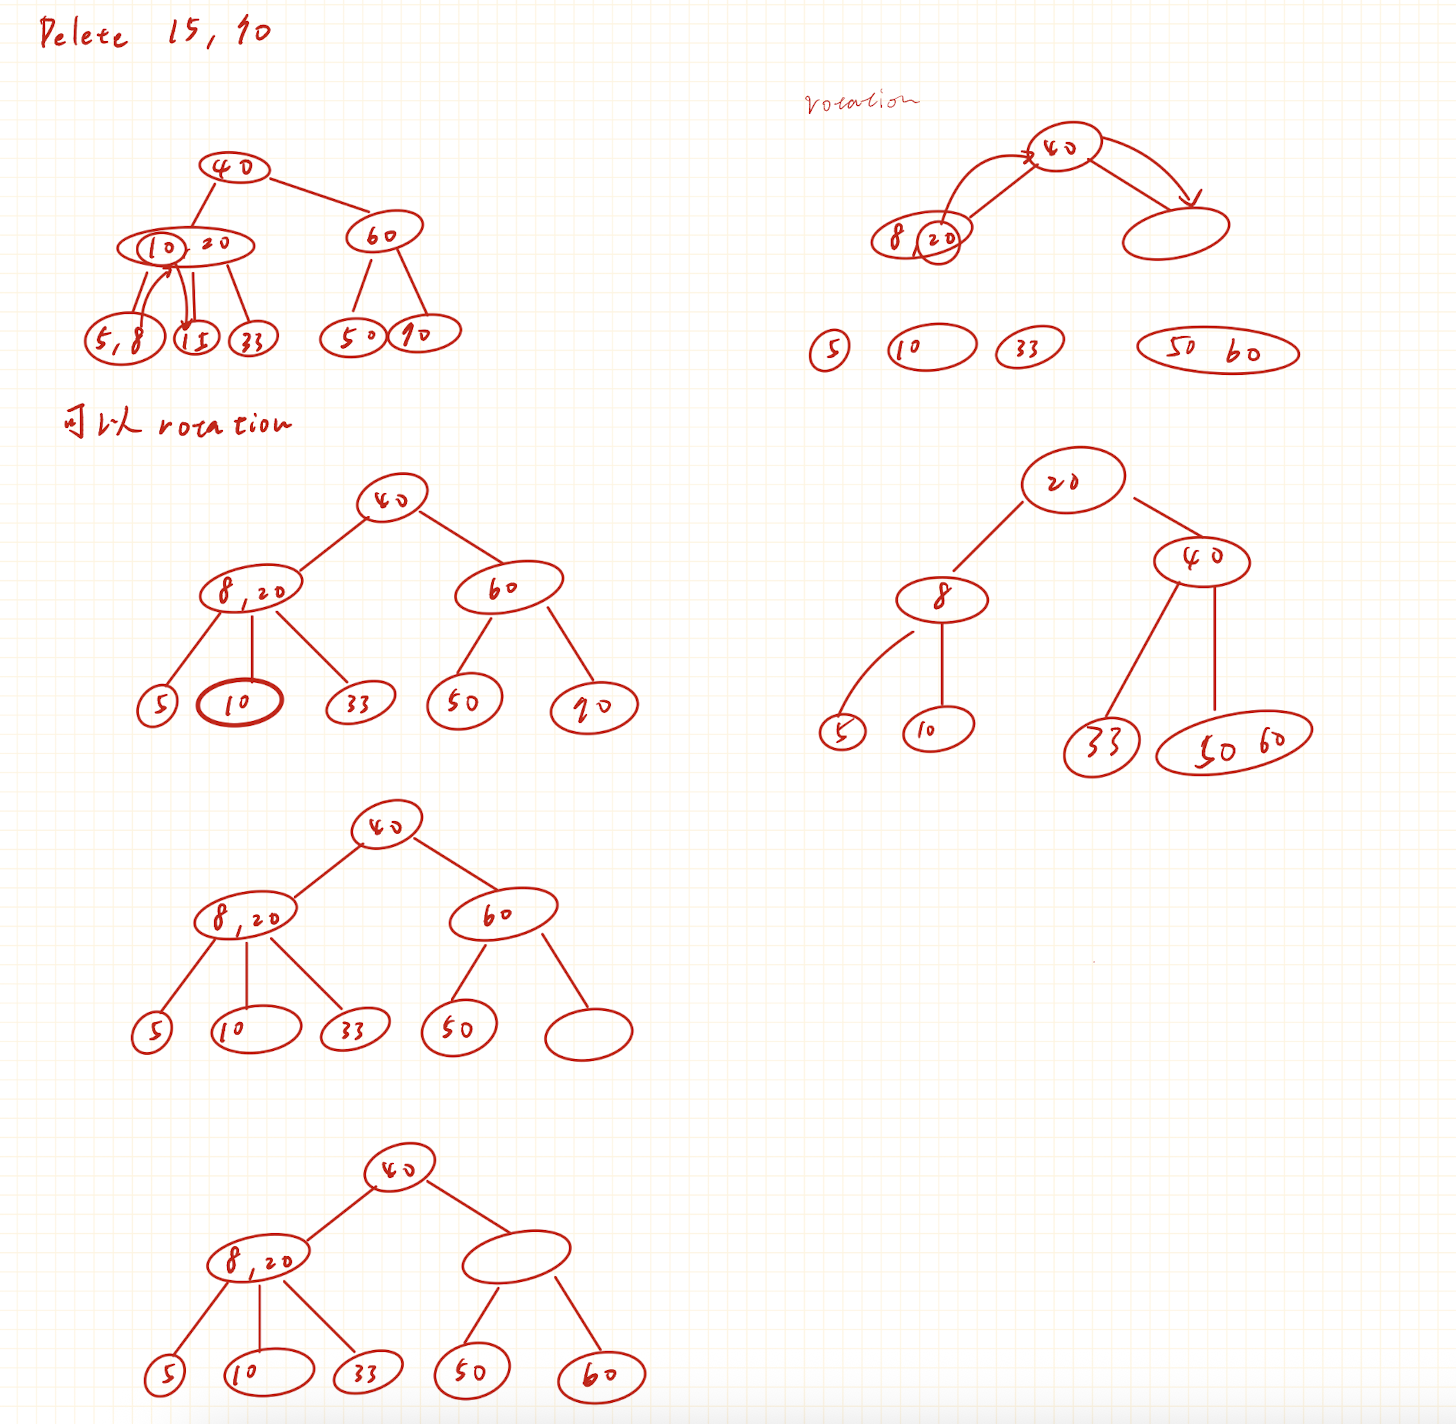
Rotation(借鍵):
-
嘗試向 兄弟節點 (相鄰的左或右)借一鍵;
-
透過 父節點分隔鍵 旋轉;
-
若成功 → 完成。
-
-
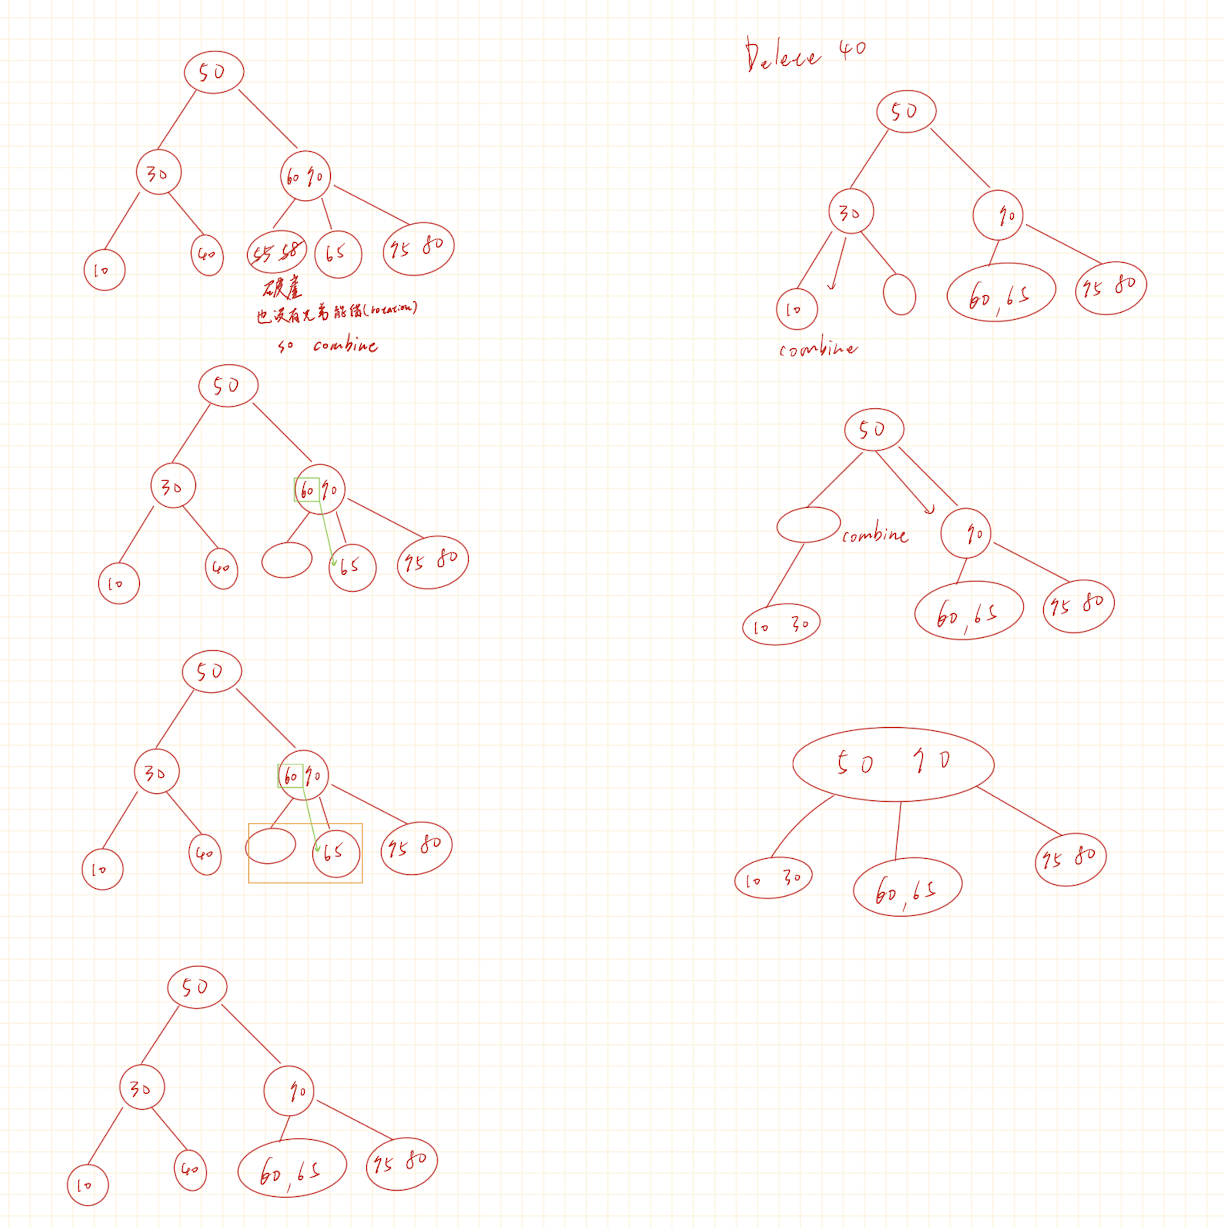
Combine / Merge(合併):
-
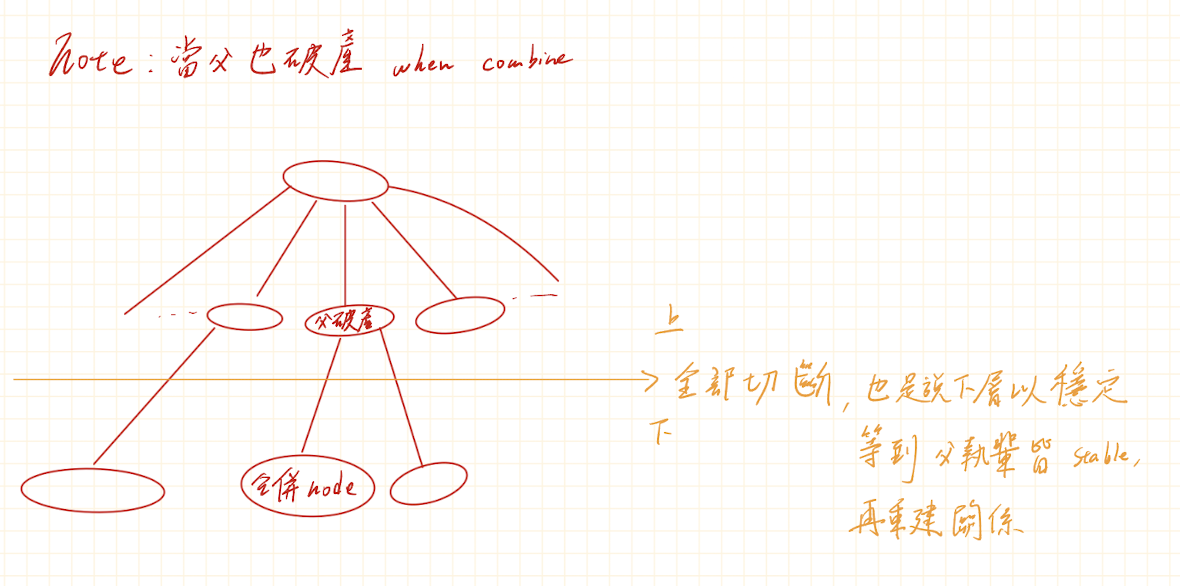
若無法旋轉,與相鄰兄弟 合併,並把父節點中的分隔鍵 下移 到合併後的新節點;
-
令 \(N \leftarrow\) 該 父節點 (父節點少了一鍵), 回到本 Case 的步驟 2 續檢查(可能向上連鎖)。
-
-
-
-
-
Case II|\(N\) 是 non-leaf
-
選替代鍵 \(y\):
-
取 前驅 (左子樹中的 最大 鍵),或
-
取 後繼 (右子樹中的 最小 鍵)。
-
-
交換並遞迴刪除:
-
用 \(y\) 取代 \(x\)(位置在 \(N\))。
-
到 \(y\) 所在的 leaf 刪除 \(y\)。該 leaf 的鍵數減一,
-
因此回到 Case I 的 underflow 檢查與修復流程。
-
-
註記
-
\(\lceil m/2\rceil - 1\) 為 非根節點 允許的最少鍵數。
-
Rotation 與 Merge 的選擇依鄰接兄弟是否有多於最小鍵數而定。
-
可能需 一路向上 修復直到根;若根空了且只有一個子樹,則將該子樹提升為新根。
Example
-
B-Tree Order 3, delete 58 55 and 40
-
Delete 15,70
\(B^+\) Tree of order m
定義 (Definition)
-
用途:ISAM(Index Sequential Access Method)。
-
分成 索引部分與葉層資料部分:Index level、Data blocks level;索引部分本身可以有多層。
-
Index level
-
結構: B-tree of order mm。
-
功能: 純索引,不放資料(只放 key 與子指標)。
-
-
Data blocks level
-
作用: 存放資料 (records)。
-
連結:各 data block 以 linked list 串接,方便順序讀取。
-
容量:每個 block 的資料數 可依題目/規格自行訂, 不必 與 index 的 order m 相同, 但是題目沒有特別說就是一樣。
-
-
葉節點連結與範圍查詢
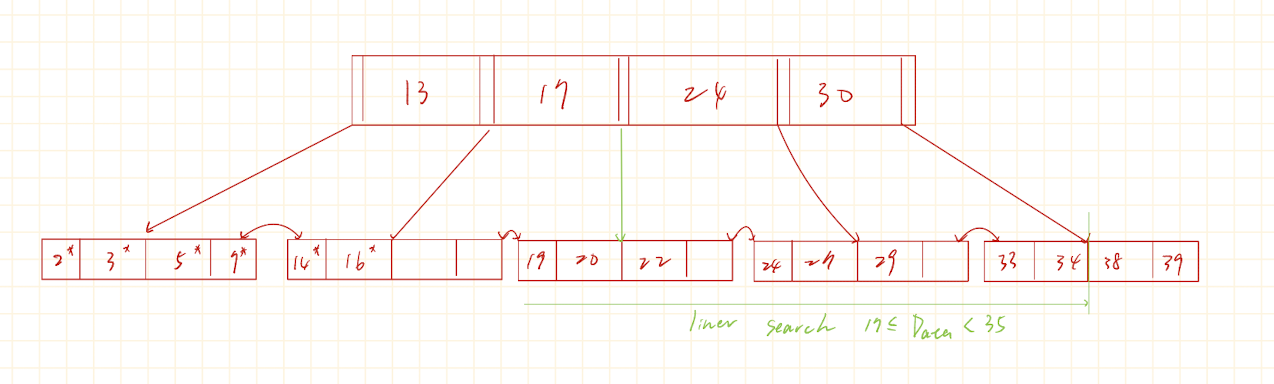
B+ Tree 的相鄰 Leaf Nodes 可以透過 Leaf Links 串接。範圍查詢先沿樹找到第一個符合條件的 Leaf,再沿葉鏈讀取後續資料,不必每讀下一頁就重新從 Root 搜尋。這與 B-link Tree 在各層用 High Key 與 Right Sibling Link 處理並行分裂的用途不同,後者見 B-Tree Variants。
分隔範圍與最右側子指標
下圖採 B+ Tree 的分隔 Key 路由示意,相等值往右側區間;不是前面一般 B-Tree 在內部節點直接命中 Key 的規則。
Rightmost Pointer(最右側子節點指標):Internal Node 有 N 個分隔 Key,就需要 N+1 個 Child Pointers,因為 N 個 Key 將搜尋範圍分成 N+1 段。例如只有 10、20 兩個 Key,仍需要三個 Child Pointers,而不是三個 Key。依圖中的邊界慣例,三段分別是小於 10、大於等於 10 且小於 20,以及大於等於 20。
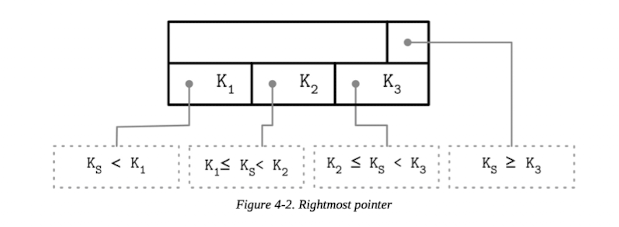
圖中的 Kₛ 是 Search Key,也就是正在查找的值;它用來與 K₁、K₂、K₃ 比較,決定走哪一個 Child Pointer,並不是額外放到最右側的 Key。當 Kₛ 大於等於 K₃,就沿 Rightmost Pointer 往下查找。
實際 Page 如何將 Rightmost Pointer 放在 Header,見 Database Internals;把它與節點 High Key 配對的另一種格式,見 B-Tree Variants。
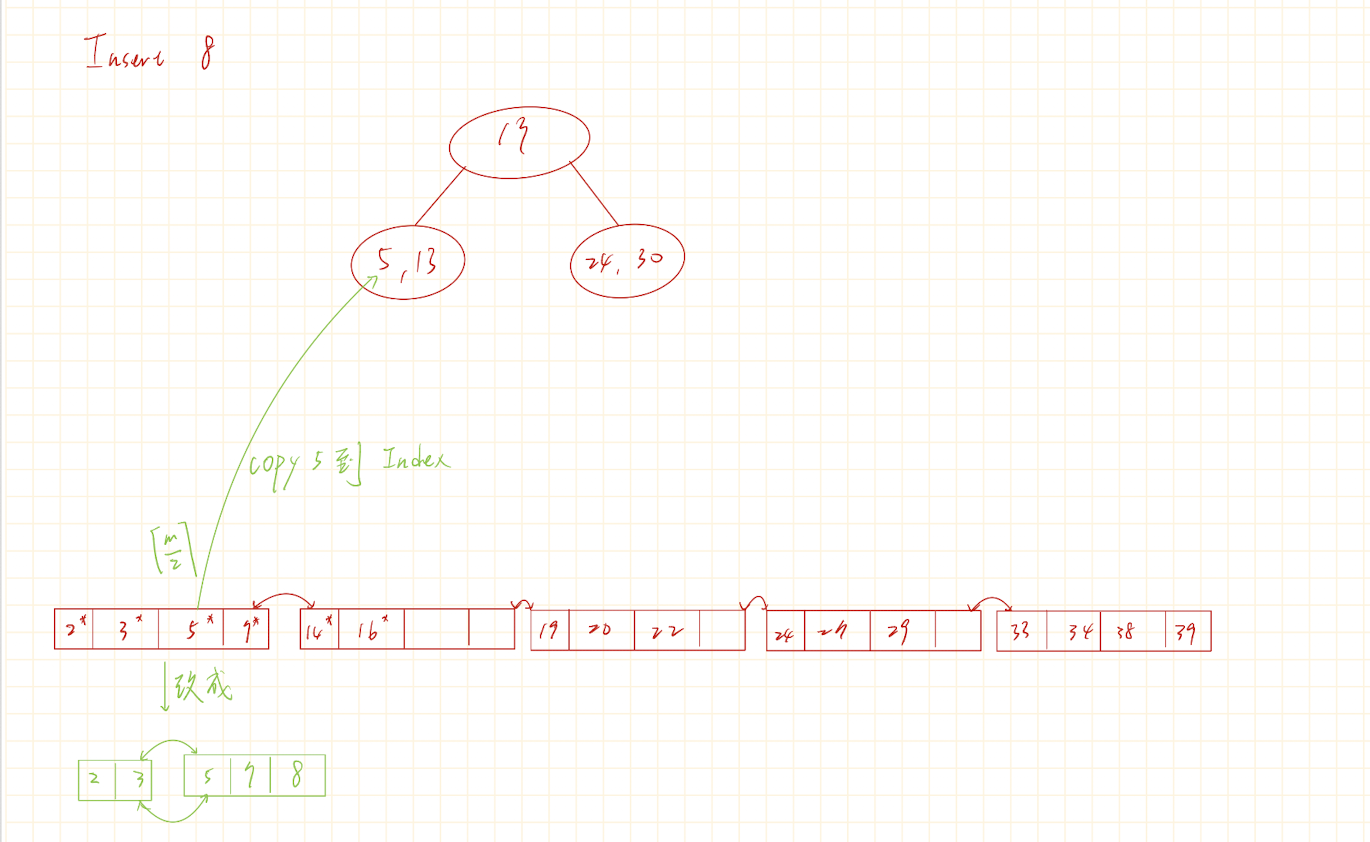
Insert a data
Delete a data
-
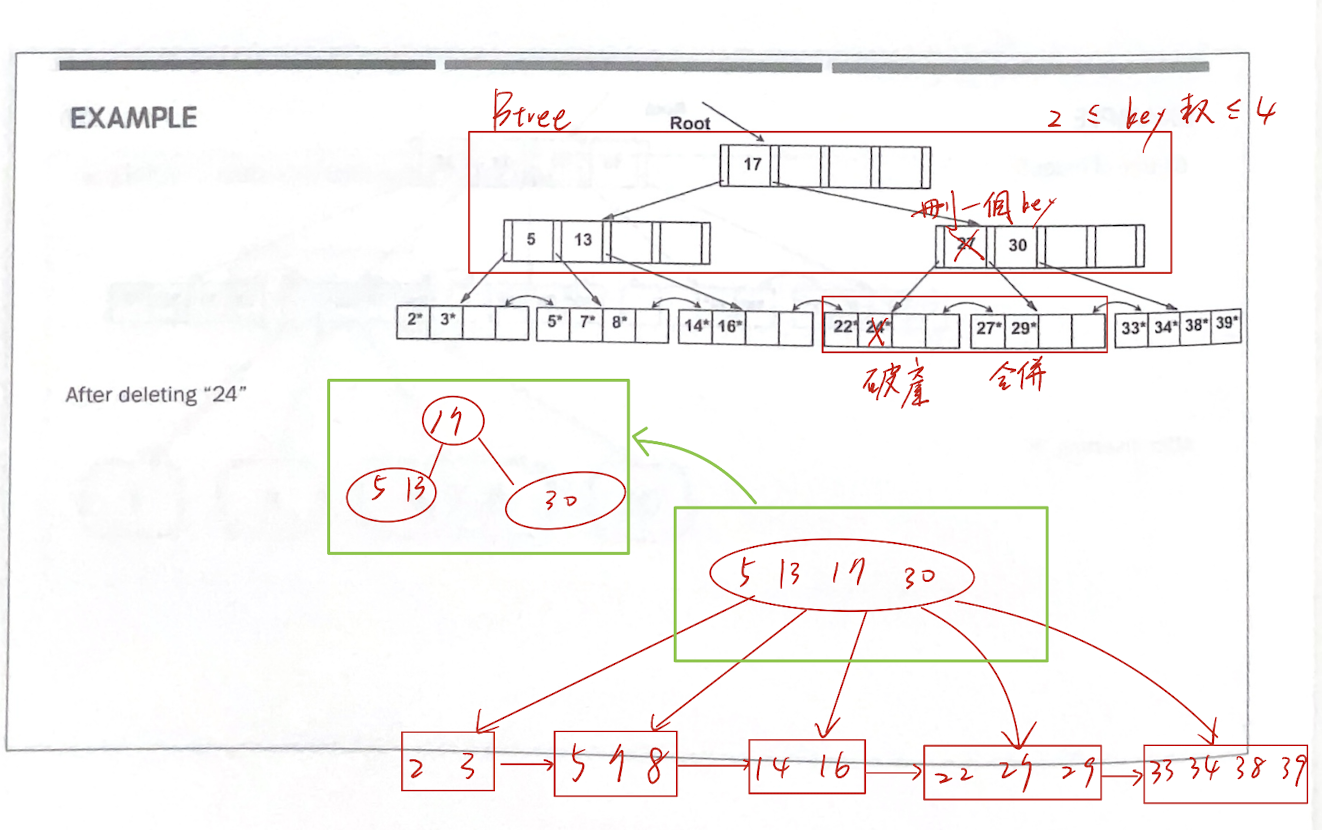
尋找要刪除的節點,例如刪除 24 → 在葉節點
[22 | 24]中找到。 -
從葉節點刪除 24 → 節點剩下
[22]。 -
檢查節點鍵值數,規則為 2 ≤ key ≤ 4。此時只有 1 個 key,不足。
-
嘗試向兄弟節點借 key,如果兄弟節點也不足,則進行合併。
-
[22]與兄弟節點[27 | 29]合併 → 得到[22 | 27 | 29]。 -
父節點 index 需要更新,原本有
[17 | 27 | 30],因為合併,27 作為 index 不再需要 → 父節點變為[17 | 30]。 -
再檢查父節點是否滿足 2 ≤ key ≤ 4,如果不足則繼續合併或往上更新。
-
若 root 最後只剩一個子節點,則降低樹高,新的 root 成為唯一的子節點。
Split 後的子指標更新
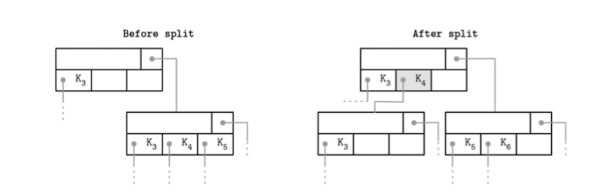
Split 與 Rightmost Pointer 更新:圖中右側子節點分裂後,原本的一個 Child 變成兩個,父節點需要加入分隔 Key K₄,以及對應的 Child Pointer。父節點原本的最右側路徑也要調整,讓 Rightmost Pointer 指向分裂後最右邊的新節點,其他搜尋範圍則由相應的 Cell 引導。
Rebalancing 與節點占用量
Rebalancing(重新分配):當某個 Page 很滿、相鄰的兄弟 Page 卻還有空間,可以先把部分 Cells 移到較空的 Page,平衡各頁面的空間使用率(Node Occupancy),延後 Split;刪除資料時,也可以從兄弟節點移入資料,避免太早 Merge。這裡關心的是資料占用空間,而不是讀寫請求集中造成的 Hot Spot。
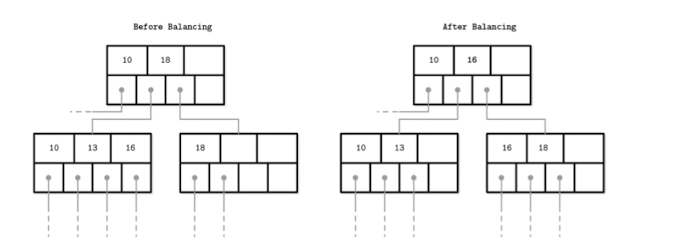
圖中調整前,左節點有 10、13、16,右節點只有 18;調整後把 16 移到右節點,變成左邊 10、13、右邊 16、18。兩個節點負責的搜尋範圍改變,因此父節點的分隔 Key 也從 18 更新為 16。
這次調整前後的樹高相同。長期提高節點填滿程度,才可能讓相同資料量使用更少的 Pages 與層數;不是每次 Rebalancing 都會降低樹高。另外,跨 Page 重新分配 Cells 是這裡的 Rebalancing,同一個 Page 內搬動 Cells、整理零碎空間則是 Compaction/Defragmentation。
節點填滿程度不平均,不等於樹高失衡。B-Tree 的高度平衡要求所有 Leaf 位於同一層,各節點不必有相同 Key 數,但仍須遵守所採模型的最低占用規則。資料庫的追加寫入最佳化可能採取不同的頁面填充策略,相關 Fastpath 與 Quickbalance 實例見 Database Internals。
Bulk Loading:由 Leaf 向上建樹
Bulk Loading 與 Bottom-Up 建樹:Bulk Loading 是一次載入整批資料;這裡討論的 B-Tree 建索引方式採用 Bottom-Up(由下往上),先建立 Leaf Pages,再逐層建立 Internal Pages,最後形成 Root。
例如要為 1~1,000,000 的資料建立索引,先按 Key 排序,再依序把資料填入 Leaf Pages,接著依各個 Leaf 所負責的範圍,建立上層的分隔 Key 與 Child Pointers。如果一層仍放不下所有指標,就繼續向上建立,直到形成 Root。這與逐筆插入、每次從 Root 尋找目標 Leaf,再於空間不足時進行 Split 的流程不同,可以減少重複搜尋與分裂的成本。
page-wise 表示「以 Page 為單位」。在這個情境中,可以理解成一頁一頁建立與填入資料,再從這批頁面建立上一層,而不是每筆資料都重新走完整的插入路徑。實作上也可以保留部分可用空間,供後續插入使用,不一定把每頁填到全滿。
Bulk Loading 強調整批處理,Bottom-Up 強調建樹方向。一般的批次匯入不一定採用 Bottom-Up;此處描述的是利用排序後的整批資料,由 Leaf 向上直接建立 B-Tree 索引的方式。