圖論基礎:DFS 與 BFS
My vault 資料結構筆記:圖論基礎:DFS 與 BFS。
基本定義和術語介紹
基本定義
-
圖形:$G=\langle V,E\rangle$,$V$ 為頂點集合,$E$ 為邊集合。
-
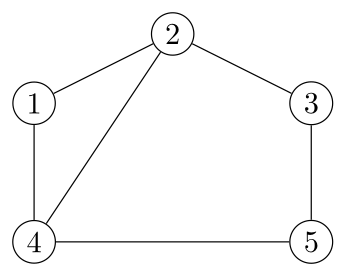
無向圖:邊為無序對 ${i,j}$。
-
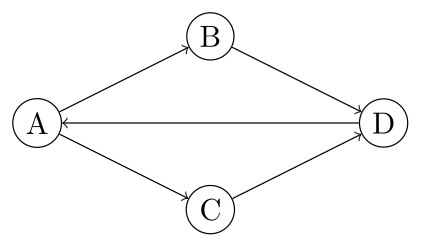
有向圖:邊為有序對 $\langle i,j\rangle$。
-
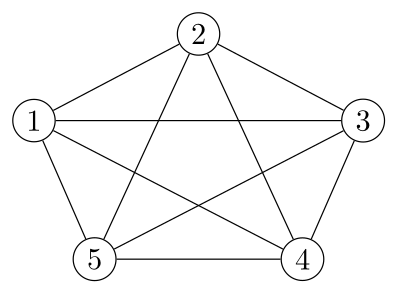
完全圖:$K_n$ 邊數 $|E|=\binom{n}{2}=n(n-1)/2$;若為有向且無自迴路,弧數 $n(n-1)$。$$示例:K_5$$
-
子圖:$G’=\langle V’,E’\rangle$,$V’\subseteq V$,$E’\subseteq E$ 且端點屬於 $V’$。
路徑與連通
-
路徑:$v_0,v_1,\dots,v_k$;無向用 ${v_{i-1},v_i}\in E$,有向用 $\langle v_{i-1},v_i\rangle\in E$。
-
長度:邊數 $k$。
-
簡單路徑:除起訖外頂點不重複。
-
環:起訖同一點的簡單路徑,長度 $\ge1$。
-
連通:無向圖任兩點間有路徑。
-
連通分量:極大連通子圖。
-
強連通:有向圖任兩點 $i,j$ 皆有 $i\to j$ 與 $j\to i$。SCC 為極大強連通子圖。
示例:$P_4$ 與 $C_5$
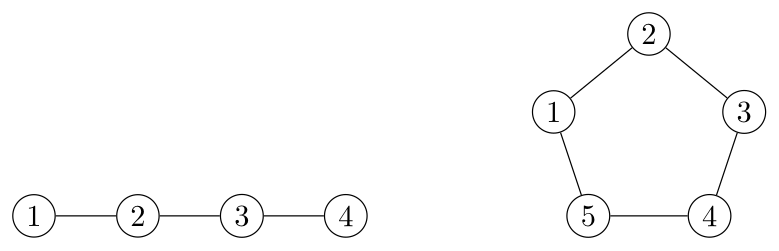
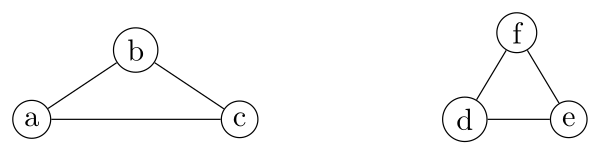
示例:兩個連通分量
次數與手搖定理
-
無向:$\sum_{v}\deg(v)=2|E|$。
-
有向:$\sum_v \deg^{+}(v)=\sum_v \deg^{-}(v)=|E|$。
-
推論:無向圖度數和為偶數。
歐拉路徑與環
-
Eulerian cycle:連通且所有頂點度為偶數。
-
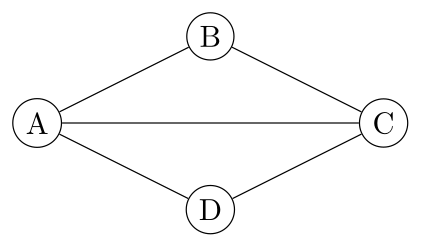
Eulerian trail:連通且恰兩頂點為奇度。
示例:Eulerian trail(兩奇度)
漢米爾頓(NP-complete)
-
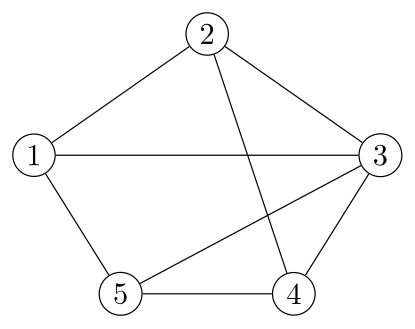
Hamiltonian cycle:經每頂點一次並回到起點。
-
Hamiltonian path:經每頂點一次但不回起點。
示例:Hamiltonian cycle
二分圖
-
定義:$V=L\cup R$,$L\cap R=\varnothing$,邊僅跨 $L$ 與 $R$。
-
等價:可二著色。
-
性質:樹必為二分圖;二分圖 $\iff$ 無奇環。
-
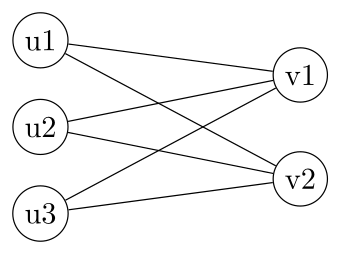
完全二分圖:$K_{m,n}$,邊數 $mn$。
示例:$K_{3,2}$
團 (Clique)
-
團:誘導子圖為完全圖的頂點子集。
-
極大團:不可再擴張。最大團:大小最大。
-
判定是否有大小 $\ge k$ 的團為 NP-complete。
頂點覆蓋 (Vertex cover)
-
$S\subseteq V$,使每條邊至少有一端點在 $S$。
-
最小頂點覆蓋:$|S|$ 最小;最佳化版 NP-hard,判定版 NP-complete。
-
二分圖有 Kőnig 定理:最小頂點覆蓋大小=最大匹配大小。
-
不是。頂點覆蓋與頂點著色是不同問題。
-
頂點覆蓋:找最小 $S\subseteq V$,使每條邊至少有一端點在 $S$。
等價:$S$ 是頂點覆蓋 ⇔ $V\setminus S$ 是獨立集。記 $\tau(G)$ 為最小覆蓋數、$\alpha(G)$ 為最大獨立集,則 $\boxed{\tau(G)+\alpha(G)=|V|}$。判定版 NP-complete。 -
頂點著色:用最少顏色給頂點上色,使相鄰頂點不同色。記色數 $\chi(G)$。
等價:把 $V$ 分成 $\chi(G)$ 個獨立集(色類)。亦即 $\chi(G)$ 是把 $V$ 分割成最少獨立集的數。對 $k\ge3$ 之 $k$-coloring 為 NP-complete。 -
反例:$K_3$ 的最小頂點覆蓋數 $\tau(K_3)=2$,但色數 $\chi(K_3)=3$,顯示二者不等價。
-
關聯重點:
-
頂點覆蓋 ↔(補集)最大獨立集。
-
頂點著色 ↔ 把 $V$ 分割成若干獨立集(與覆蓋數無直接等價)。
-
在二分圖(可 2-著色)中,最小頂點覆蓋大小=最大匹配大小(Kőnig 定理),但這仍與「著色」不同概念。
-
-
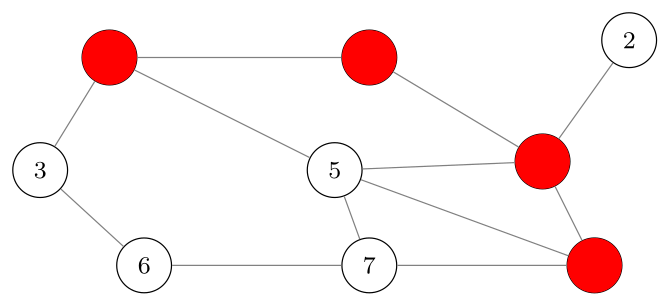
示例:最小覆蓋為 Vertex Cover
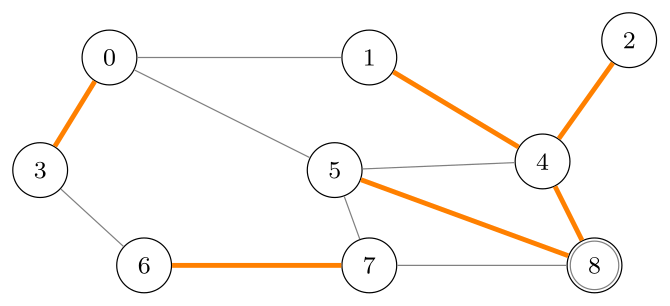
 示例:最小覆蓋為 Edge Cover
常用符號
-
$n=|V|$ 頂點數量,$m=|E|$ 邊的數量;無向 $m=\binom{n}{2}$;有向無自迴路 $m=n(n-1)$。
-
路徑長度=邊數;簡單路徑不重頂點;環為閉合簡單路徑。
快速檢核
-
==所有的演算法沒有辦法解決 Negative cycle ==
-
Eulerian cycle:連通 + 全偶數 $Degree$。
-
Eulerian trail:連通 + 恰 2 $Degree$。
-
二分圖:二著色或找奇環。
-
==度數和驗證:無向 $\sum \deg=2m$;有向 $\sum \deg^{+}=\sum \deg^{-}=m$==。
圖的表方式
==Adjacency Matrix(相鄰矩陣)==
令圖 $G=(V,E)$,$|V|=n$。相鄰矩陣為 $n\times n$ 矩陣 $A$,規則:
-
無向圖:$A[i,j]=1$ 若 ${i,j}\in E$,否則 $0$。
-
有向圖:$A[i,j]=1$ 若 $\langle i,j\rangle\in E$,否則 $0$。
-
簡單圖預設 $A[i,i]=0$(無自迴路)。
範例
G1(無向,$K_4$)
$$
A=\begin{bmatrix}
0&1&1&1\
1&0&1&1\
1&1&0&1\
1&1&1&0
\end{bmatrix}
$$
有向例(邊:$1\to2,1\to3,2\to1,2\to3$)
$$
A=\begin{bmatrix}
0&1&1\
1&0&1\
0&0&0
\end{bmatrix}
$$
- 第 $i$ 列和 $=\deg^{+}(i)$(出度),第 $j$ 欄和 $=\deg^{-}(j)$(入度)。
性質
-
無向圖:$A$ 為對稱矩陣,$A[i,j]=A[j,i]$。
-
無向圖:第 $i$ 列(或欄)元素和 $=\deg(i)$。
-
有向圖:第 $i$ 列和 $=\deg^{+}(i)$,第 $i$ 欄和 $=\deg^{-}(i)$。
-
元素總和與邊數(可以畫的最多邊):
-
無向圖(無自迴路):$$\sum_{i,j}A[i,j]=2m,\quad m=\frac12\sum_{i,j}A[i,j].$$
-
有向圖:$$\sum_{i,j}A[i,j]=m.$$
-
-
==空間 $O(n2)$。查詢是否相鄰 $O(1)$;掃一整列求度或鄰點 $O(n)$;全圖統計(如總邊數)$O(n2)$。==
-
==適合 dense graph;稀疏圖多用 adjacency list==。
快速公式
-
==無向:$\deg(i)=\sum_{j}A[i,j]$。==
-
==有向:$\deg^{+}(i)=\sum_j A[i,j],\ \deg^{-}(i)=\sum_j A[j,i]$。==
-
==邊數:無向 $m=\tfrac12\sum_{i,j}A[i,j]$;有向 $m=\sum_{i,j}A[i,j]$。==
Incidence matrix [ALGO]
-
有向圖(無自迴路):$B\in\mathbb{R}^{|V|\times|E|}$,$b_{ij}=-1$ 若邊 $e_j$ 從頂點 $i$ 離開;$b_{ij}=1$ 若 進入;否則 $0$。每欄恰有一個 $-1$ 與一個 $1$。
-
無向圖:$b_{ij}=1$ 若頂點 $i$ 與邊 $e_j$ 相鄰;否則 $0$。每欄有兩個 $1$。
有向例(邊:$e_1:2\to1,\ e_2:1\to3,\ e_3:4\to3,\ e_4:1\to4$)
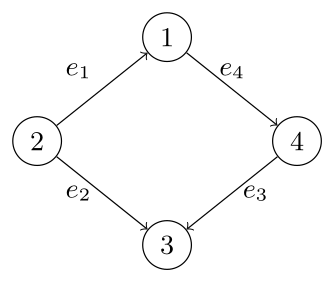
$$
B=\begin{bmatrix}
\ \ 1 & -1 & \ ,0 & -1\
-1 & \ ,0 & \ ,0 & \ ,0\
\ 0 & \ ,1 & \ ,1 & \ ,0\
\ 0 & \ ,0 & -1 & \ ,1
\end{bmatrix}
\quad(\text{rows }1..4,\ \text{cols }e_1..e_4)
$$
無向例(同一張圖,忽略方向)
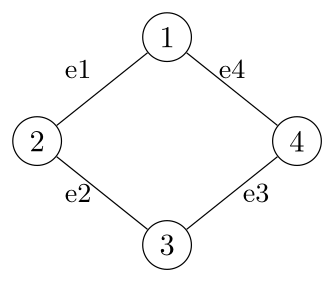
$$
B_{\text{und}}=\begin{bmatrix}
1 & 1 & 0 & 1\
1 & 0 & 0 & 0\
0 & 1 & 1 & 0\
0 & 0 & 1 & 1
\end{bmatrix}
\quad(\text{rows }1..4,\ \text{cols }e_1..e_4)
$$
備註:若允許自迴路,常令有向圖的該欄出現 $+1$ 與 $-1$ 在同一列(或定義為 $2$ 與 $0$ 的變體)。
==Adjacency Lists(相鄰串列)==
==定義與結構==
-
圖 $G=(V,E)$,$|V|=n, |E|=m$。
-
用陣列
Vertex[1..n]作為每個頂點的表頭;每個表頭指向一條串列。 -
串列節點欄位:
(neighbor, next)。
無向 vs 有向
-
無向邊 ${u,v}$ 以兩筆節點記錄:$u\to v$、$v\to u$。
-
串列節點總數 $=2m$。
-
第 $i$ 條串列長度 $=\deg(i)$。
-
$\displaystyle \sum_{i=1}^{n}\text{len}(i)=2m$。
-
-
有向邊 $\langle u,v\rangle$ 只出現在 $u$ 的串列。
-
串列節點總數 $=m$。
-
第 $i$ 條串列長度 $=\deg^{+}(i)$,掃全表可得入度 $\deg^{-}$。
-
$\displaystyle \sum_{i=1}^{n}\text{len}(i)=m$。
-
==空間複雜度==
-
表頭:$O(n)$。
-
串列節點:無向 $2m$、有向 $m$。
-
總空間:$O(n+m)$(適合稀疏圖)
邊數範圍與量級
-
無向簡單圖:$0 \le m \le \binom{n}{2}=\Theta(n^2)$;樹:$m=n-1=\Theta(n)$。
-
有向無自迴路:$0 \le m \le n(n-1)=\Theta(n^2)$。
==對複雜度的影響(以相鄰串列為例)==
-
空間:$O(n+m)$
-
稀疏(如樹,$m=n-1$):$O(n)$。
-
稠密(近完全圖,$m=\Theta(n2)$):$O(n2)$。
-
-
BFS/DFS:$O(n+m)$
-
稀疏:$O(n)$。
-
稠密:$O(n^2)$。
-
-
列舉所有邊:$O(m)$,稀疏 $O(n)$;稠密 $O(n^2)$。
對照相鄰矩陣:空間固定 $O(n^2)$;是否相鄰查詢 $O(1)$,列舉鄰點 $O(n)$。
常見操作時間
-
列舉鄰點
Adj(v):$O(\deg(v))$。 -
取得度數:$O(\deg(v))$;若表頭存長度則 $O(1)$。
-
測試是否相鄰
(u,v):掃 $u$ 串列 $O(\deg(u))$;若用雜湊集合可期望 $O(1)$。 -
新增邊:無向需兩筆 $O(1)$;有向一筆 $O(1)$。
-
刪除邊:$O(\deg(u))$(或以雙向鏈結/雜湊降至期望 $O(1)$)。
-
建表(給定邊集合):$O(n+m)$。
-
BFS/DFS:$O(n+m)$。
何時用
-
相鄰串列:稀疏圖($m\ll n^2$),需快速列舉鄰點。
-
相鄰矩陣:稠密圖或需要 $O(1)$ 相鄰查詢。
==求 adjacency list 邊數==
-
求 $m=|E|$。
-
有向圖:每條邊在一個串列出現一次 → 總節點數 $=m$。
-
無向圖:每條邊在兩個串列出現 → 總節點數 $=2m$。
演算法
s = 0
for i = 1..V:
    p = head[i]
    while p ≠ NIL:
        s = s + 1
        p = p.next
return s        // 有向圖
// 無向圖回傳 s/2
-
正確性
-
$s=\sum_{i=1}^{V}\text{len}(i)$。
-
有向:$s=m$。
-
無向:$s=2m$,所以回傳 $s/2$。
-
-
時間複雜度:外層跑 $V$ 次,內層每個串列節點剛好訪一次。 $\Rightarrow O(V+E)$。
相鄰多元串列 (Adjacency Multilist) [DS]
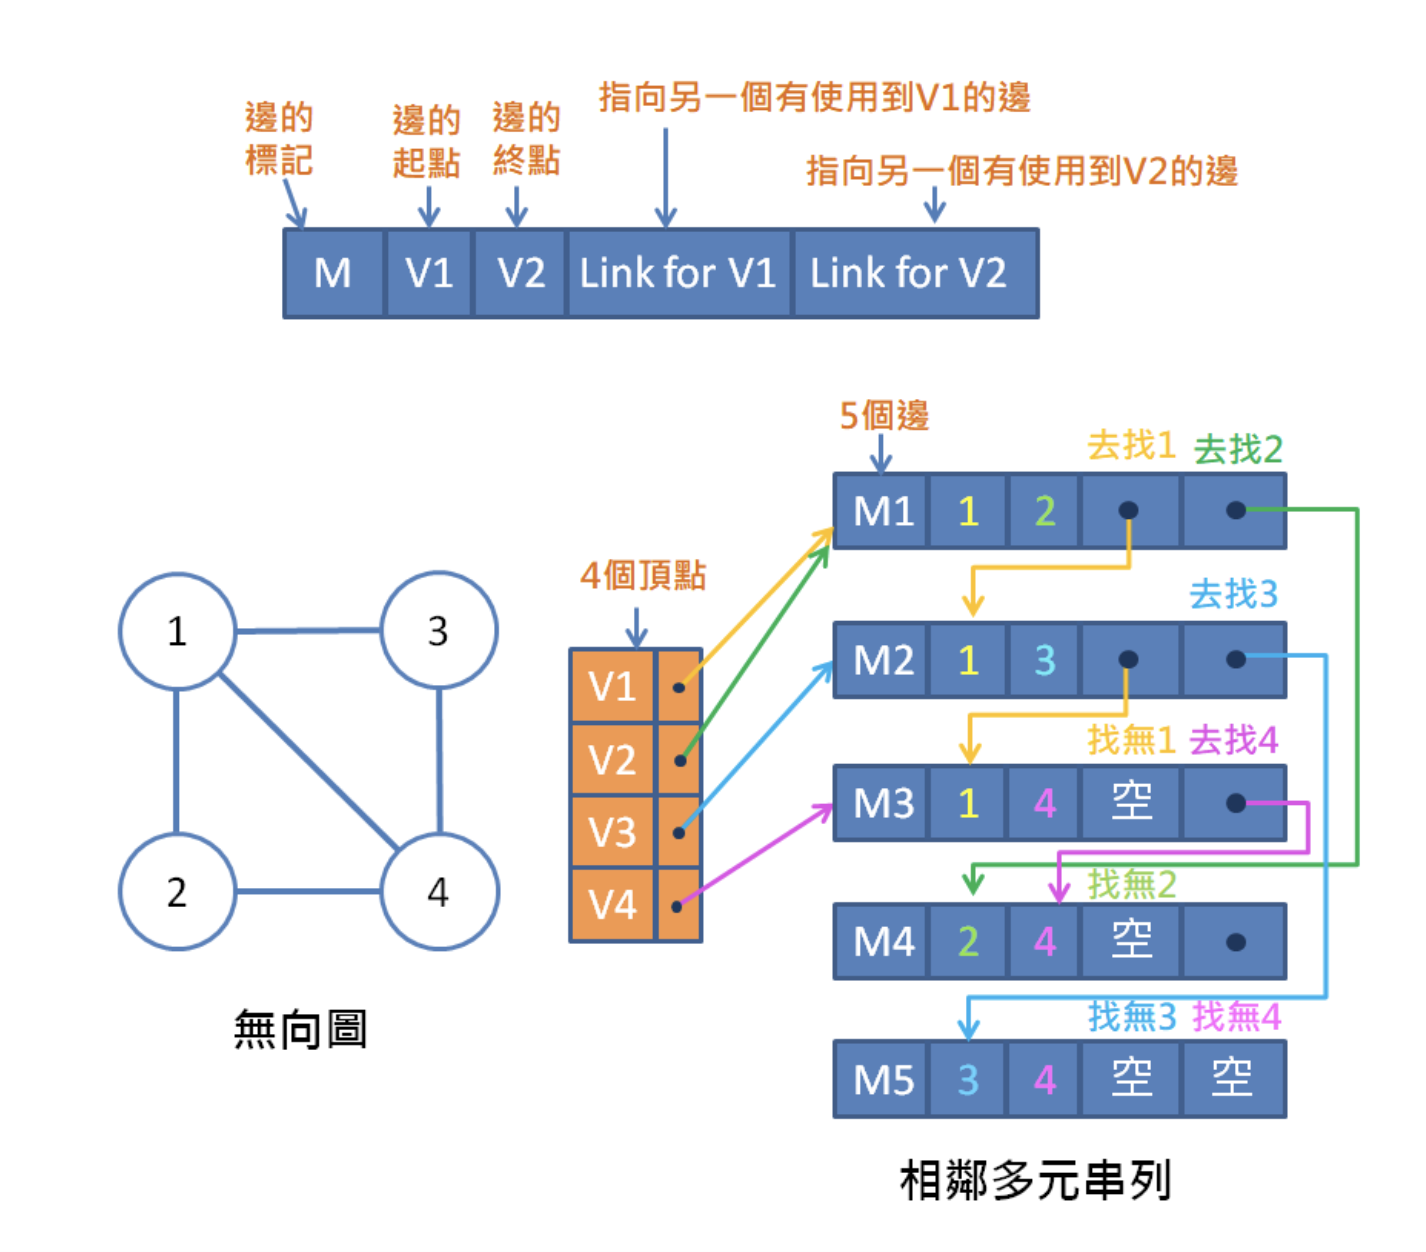
- ==這個簡單來說就是 V1 有用到的所有邊他都會連過去,所以第一個 list 表達了 edge(1->2),這個邊然後所以他就會把 Link for V1 連到有用到 V1 的其他邊,V2 同個概念==
Index + Array
結構
-
$\text{index}[1..n+1]$:頂點起始位置。第
i個頂點的鄰居在 $\text{adj}[\text{index}[i] .. \text{index}[i+1-1]$。 -
$\text{adj}[1..L]$:連續儲存所有鄰點;無向 $L=2m$,有向 $L=m$。
$$
\deg(i)=\mathrm{index}[i+1]-\mathrm{index}[i].
$$
範例(無向 $K_4$)
鄰居:$N(1)={2,3,4},\ N(2)={1,3,4},\ N(3)={1,2,4},\ N(4)={1,2,3}$
index = [1, 4, 7, 10, 13]
adj   = [2,3,4, 1,3,4, 1,2,4, 1,2,3]
查 $3$ 的鄰居:$\text{adj}[\text{index}[3] .. \text{index}[4]-1] = \text{adj}[7..9] = {1,2,4}$。
$$\deg(3)=10-7=3.$$
基本操作
-
列舉鄰點:
for k = index[i] .. index[i+1]-1: v = adj[k],時間 $O(\deg(i))$。 -
是否相鄰 $(i,v)$:線性掃 $O(\deg(i))$;若區間排序則二分 $O(\log \deg(i))$。
-
BFS/DFS:$O(n+m)$。
建表(從邊集合)
-
累計度數(無向邊兩端各 $+1$)。
-
度數做前綴和得
index。 -
走一次邊集合,把鄰點放入對應區間(每頂點用遞增游標)。
時間 $O(n+m)$,空間 $O(n+L)$。
空間複雜度
$$
O(n+L)=
\begin{cases}
O(n+2m) & \text{無向}\
O(n+m) & \text{有向}
\end{cases}
$$
Graph Traversal
DFS
-
輸入:圖 $G=(V,E)$、起點 $s$;鄰接串列按「編號遞增」掃描則序固定。
-
目的:走訪與 $s$ 可達之所有頂點(或全圖)。
-
複雜度:==鄰接串列 $O(V+E)$;矩陣 $O(V^2)$。==
-
空間:遞迴或堆疊 $O(V)$。
-
性質:==每點只標記一次;走到無未訪鄰點就回溯。不同起點或鄰接順序會產生不同走訪序,如果設定只能由小點走到大點順序會可以爲一==。
-
例(右圖,從 $1$ 並按遞增掃鄰點):$1,2,4,8,5,6,3,7$。
DS 版的寫法 單純走訪
遞迴版(visited 為全域)
// G: adjacency list, vertices are 1..V
bool visited[MAXV];

void dfs(int v) {
    visited[v] = true;
    for (int w : G[v]) {          // 按既定順序掃鄰點
        if (!visited[w]) dfs(w);
    }
}

// 若要全圖
void dfs_all(int Vn) {
    for (int v = 1; v <= Vn; ++v)
        if (!visited[v]) dfs(v);
}
-
全圖 DFS 的意思是:圖可能不連通,從編號順序掃一遍,對每個尚未訪問的頂點再啟動一次 DFS,直到所有頂點都被標記。結果是一個DFS 森林(多棵 DFS 樹),而不是「為每個點都各自跑一次 DFS」。
-
你可以輸出一條全域發現序(preorder):把每次啟動的 DFS 訪問序串接起來。
-
也可記完成序(postorder),或記每個點的父節點形成森林。
-
-
例:掃描順序為遞增;圖有三個分量 $C_1={1,2,3}$,$C_2={4}$,$C_3={5,6}$. 全圖 DFS 的發現序可能是:$1,2,3,4,5,6$;森林根為 ${1,4,5}$。
範例
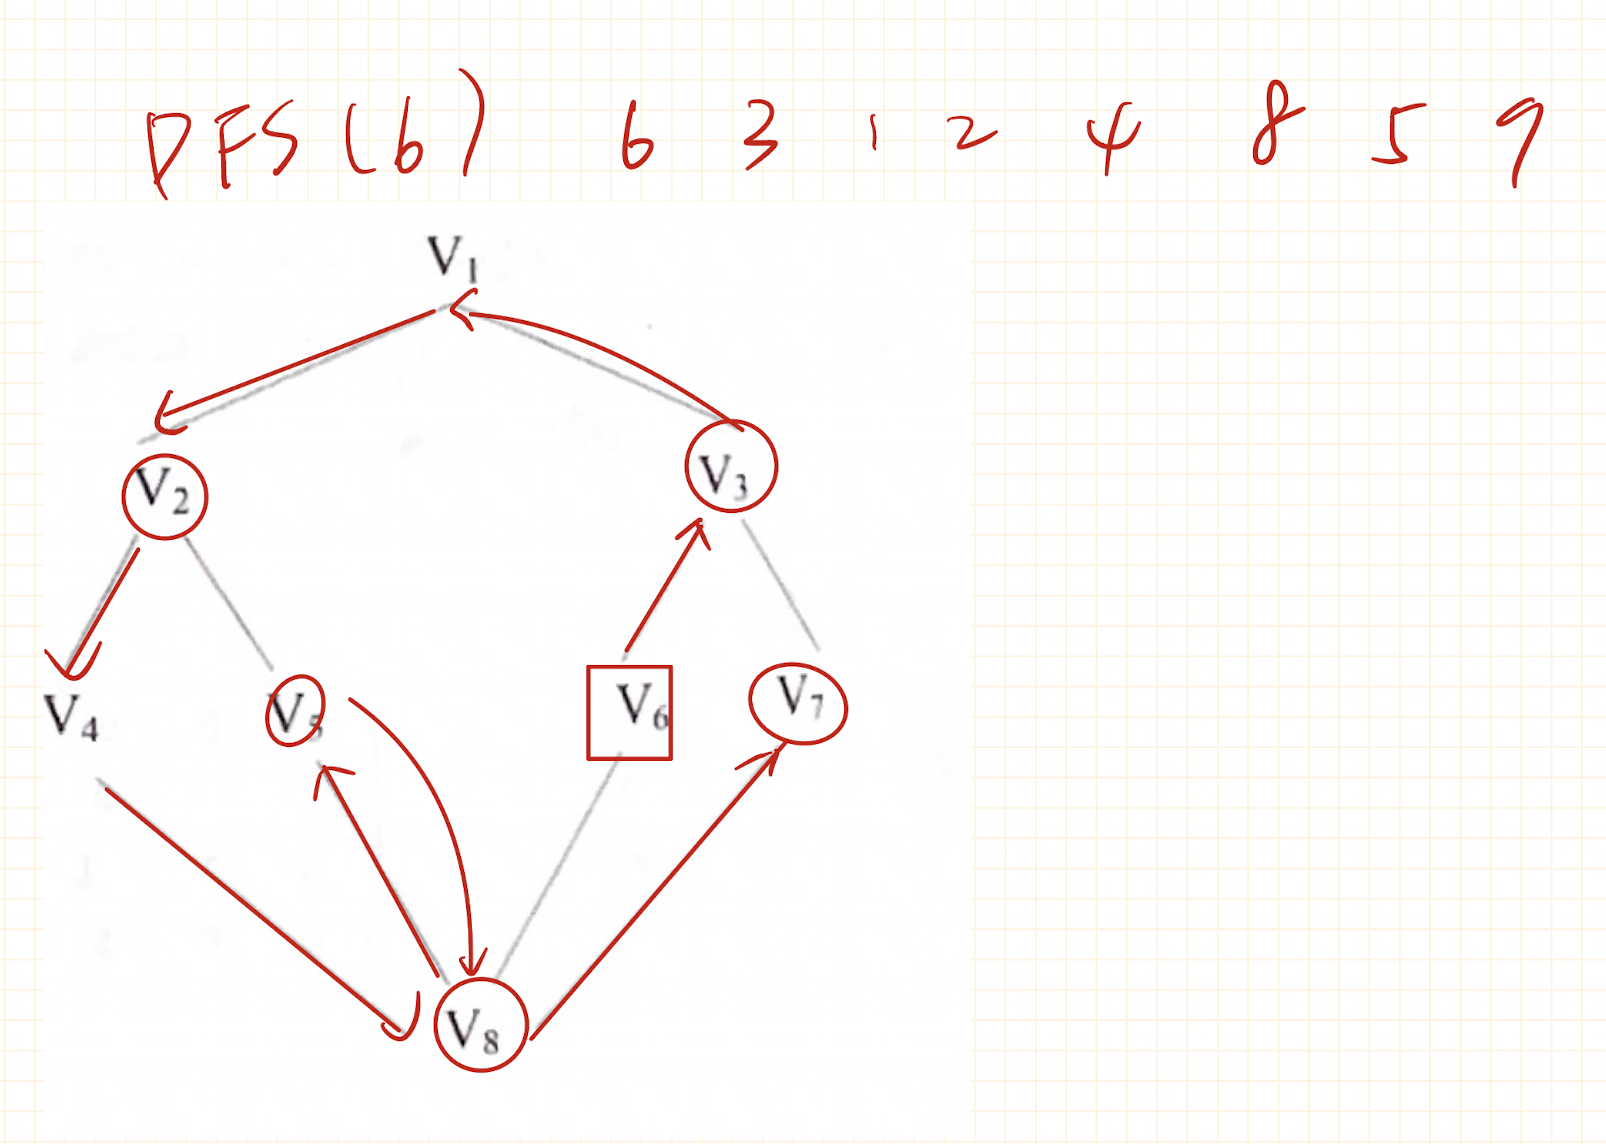
疊代版
void dfs_iter(int s) {
    vector<int> it(MAXV, 0);      // 每個頂點的鄰接迭代索引
    vector<int> S; S.push_back(s);
    visited[s] = true;
    while (!S.empty()) {
        int v = S.back();
        if (it[v] < (int)G[v].size()) {
            int w = G[v][it[v]++];
            if (!visited[w]) { visited[w] = true; S.push_back(w); }
        } else {
            S.pop_back();         // 無未訪鄰點 → 回溯
        }
    }
}
CLRS 版的寫法 著色法
DFS 邊的四種類型 (Types of Edges in DFS)
當我們從一個頂點 u 探索到它的鄰居 v 時,根據 v 當下的狀態(顏色),我們可以將邊 (u, v) 分成以下四種,==直得注意的是如我今天是 undirected graph 他只有 Tree edge 和 Back edge,未經過的就是 Back edge,有經過的就是 Tree edge==:
-
樹邊 (Tree Edge):
-
定義: 如果在探索邊
(u,v)時,v是第一次被發現的(顏色是白色的),那麼(u,v)就是一條樹邊。 -
白話解釋: 這是你在 DFS 過程中「開疆拓土」、探索未知領域時走的路。所有樹邊合在一起,會構成一棵「DFS 樹」或一片「DFS 森林」。
-
-
反向邊 (Back Edge):
-
定義: 邊
(u,v)連接了一個頂點u到它在 DFS 樹中的一個祖先 (ancestor)v。 -
白話解釋: 你沿著一條路一直往下走 (
u是v的後代),突然發現一條小路可以讓你抄捷徑回到你之前經過的某個路口 (v)。只要有 Back Edge,就代表圖中有環路 (cycle)。
-
-
前向邊 (Forward Edge):
-
定義: 邊
(u,v)是一條非樹邊,它連接了一個頂點u到它在 DFS 樹中的一個後代 (descendant)v。 -
白話解釋: 你正在路口
u,發現一條非官方的捷徑,可以直接跳到你沿著官方路線未來才會走到的某個路口v。
-
-
交叉邊 (Cross Edge):
-
定義: 所有不屬於以上三種的邊。這種邊會連接兩個不互為祖先或後代的頂點。
-
白話解釋: 你發現一條路,它通往的地方跟你現在走的這條路完全無關。它可能通往:
-
另一棵完全不同的 DFS 樹。
-
同一棵 DFS 樹中,一個已經被你完全探索完畢的分支。
-
-
判斷規則總表
演算法的核心是利用頂點顏色和發現時間 (discovered-time, d) 來判斷。以下是判斷的完整流程:
當從 u 探索到 v 時… |
v 的顏色是… |
額外條件 | 判斷結果 (邊 (u,v) 是…) |
|---|---|---|---|
| 情況 1 | 白色 (WHITE) | (無) | 樹邊 (Tree Edge) |
| 情況 2 | 灰色 (GRAY) | (無) | 反向邊 (Back Edge) |
| 情況 3 | 黑色 (BLACK) | 需比較發現時間: 如果 u.d < v.d |
前向邊 (Forward Edge) |
| 情況 4 | 黑色 (BLACK) | 需比較發現時間: 如果 u.d > v.d |
交叉邊 (Cross Edge) |
為什麼規則是這樣設計的?(規則背後的邏輯)
-
v 是白色 (WHITE):
-
邏輯: 白色代表「從未被訪問過」。所以當你從
u走到v時,你就是第一個發現v的人。這自然就構成了 DFS 樹的一部分。 -
結論: Tree Edge。
-
-
v 是灰色 (GRAY):
-
邏輯: 灰色代表「探索已開始,但還沒結束」。如果你從
u能走到一個灰色的v,這意味著v的探索函式先被呼叫,然後在v的探索過程中,又呼叫了u的探索函式。這就確定了v是u的祖先。 -
結論: Back Edge。
-
-
v 是黑色 (BLACK):
-
邏輯: 黑色代表「這個頂點以及它的所有後代都已經被完全探索完畢」。這時,
u和v的關係就不在同一條「正在進行中」的路徑上了,需要靠它們被發現的先後順序 (.d值) 來判斷。-
如果
u.d < v.d: 代表u比v更早被發現。既然u先開始,後來又走到了v,這表示v只能是u在 DFS 樹中的一個後代。- 結論: Forward Edge。
-
如果
u.d > v.d: 代表v比u更早被發現。既然v先被發現,而且現在已經是黑色的(探索完畢),而u卻現在才走到它,這表示它們倆肯定不在同一條直系分支上。v屬於一個已經被徹底搞定的分支。- 結論: Cross Edge。
-
-
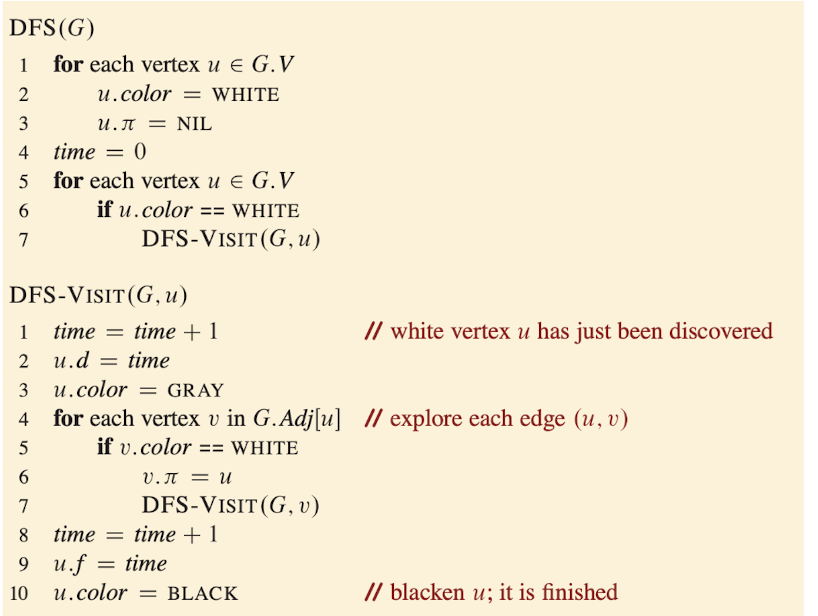
演算法
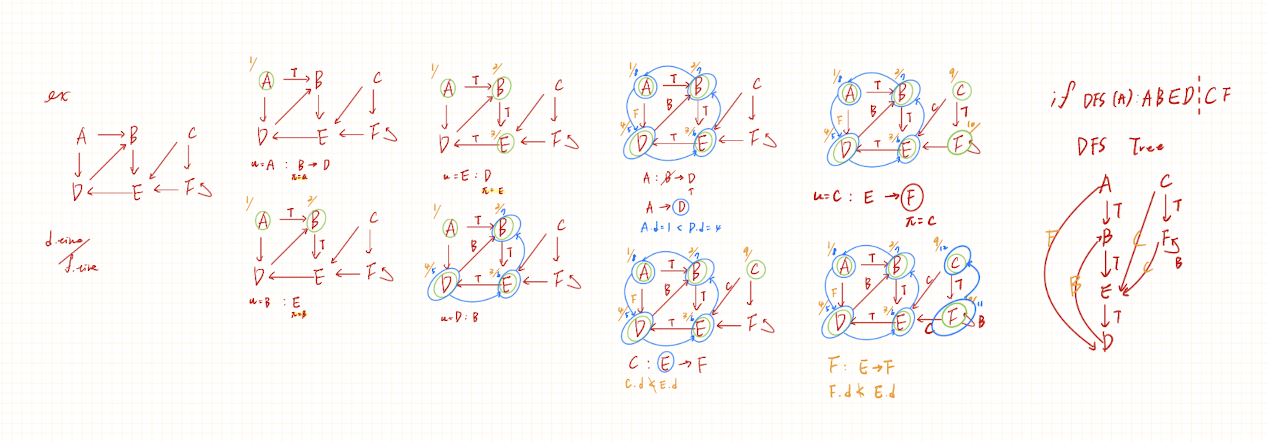
BFS
DS 版的寫法 單純走訪
-
功能:分層擴張,求最短邊數距離 $dist$(無權、非負邊)。
-
複雜度:鄰接串列 $O(V+E)$;空間 $O(V)$。
void bfs(int s) {
    queue<int> q;
    vector<int> dist(MAXV, -1);
    dist[s] = 0; visited[s] = true; q.push(s);
    while (!q.empty()) {
        int v = q.front(); q.pop();
        for (int w : G[v]) if (!visited[w]) {
            visited[w] = true;
            dist[w] = dist[v] + 1;
            q.push(w);
        }
    }
}
範例
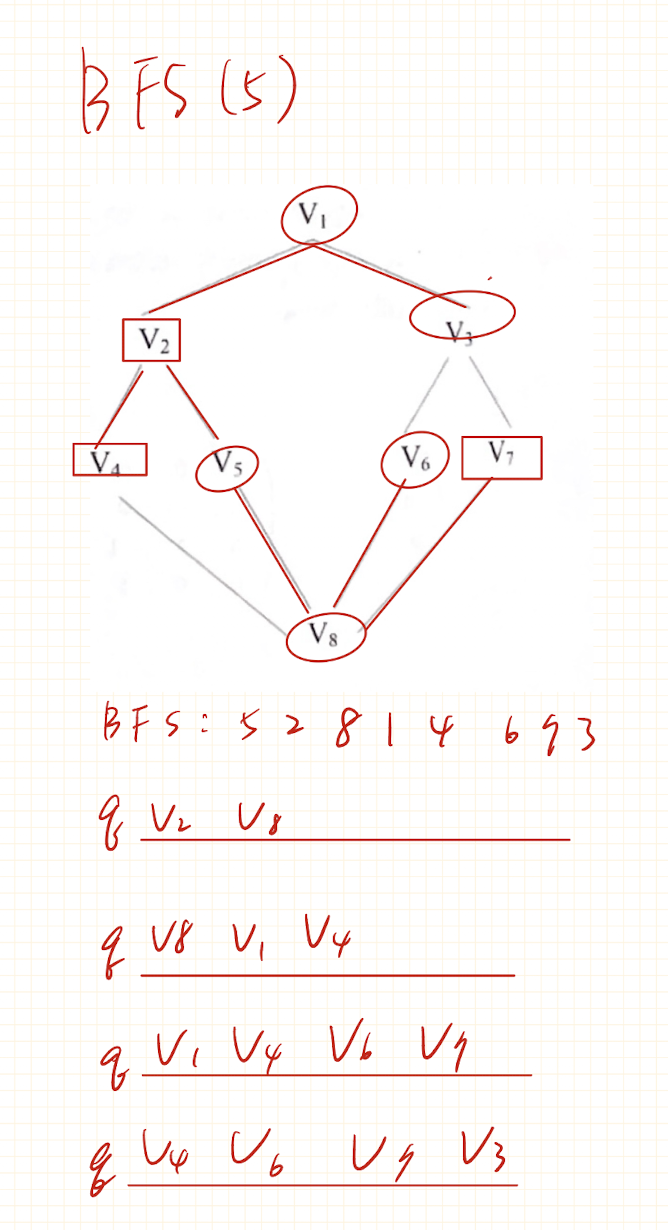
演算法版本 BFS 著色法
流程
-
初始化(除起點 $s$ 以外)
color[u]=WHITE; d[u]=∞; π[u]=NIL; -
設起點
color[s]=GRAY; d[s]=0; π[s]=NIL; Enqueue(Q,s); -
迴圈
取出u=Dequeue(Q);掃Adj[u]:
若color[v]==WHITE,則
color[v]=GRAY; d[v]=d[u]+1; π[v]=u; Enqueue(Q,v);
掃完把u設為BLACK。
顏色語意:
WHITE未發現;GRAY已入隊但鄰居未掃完;BLACK已完成。
輸出意義
-
d[v]:從 $s$ 到 $v$ 的最短邊數距離。 -
π[v]:BFS 樹的父節點。沿π可回溯最短路,也就是說紀錄哪個點到哪個點(就是說從哪個點過來的)。 -
走訪順序依層次而定,與鄰接串列內的掃描順序一致。
正確性直觀
- 佇列是 FIFO,節點依距離非遞減出隊;首次發現 $v$ 即得最短距離
d[u]+1。
複雜度
-
使用相鄰串列:每頂點入隊出隊各一次,每邊在無向圖被檢視兩次
$\Rightarrow\ O(V+E)$。 -
相鄰矩陣時,掃鄰點需 $O(V)$ 次
$\Rightarrow\ O(V^2)$。
演算法
void bfs(int s) {
    for (int u = 1; u <= V; ++u) {        // 初始化
        color[u] = WHITE; d[u] = INF; pi[u] = NIL;
    }
    queue<int> Q;
    color[s] = GRAY; d[s] = 0; pi[s] = NIL;
    Q.push(s);

    while (!Q.empty()) {
        int u = Q.front(); Q.pop();
        for (int v : Adj[u]) {
            if (color[v] == WHITE) {
                color[v] = GRAY;
                d[v] = d[u] + 1;
                pi[v] = u;
                Q.push(v);
            }
        }
        color[u] = BLACK;
    }
}
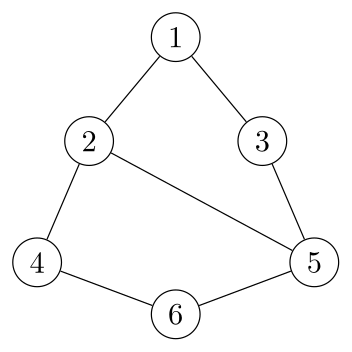
起點 $s=1$。BFS(按編號遞增掃鄰點):
-
層次:$L_0={1}$,$L_1={2,3}$,$L_2={4,5}$,$L_3={6}$。
-
距離:
$$
d[1]=0,\quad d[2]=d[3]=1,\quad d[4]=d[5]=2,\quad d[6]=3.
$$ -
佇列追蹤:
$[1]\ \Rightarrow$ 出隊 $1$ 變黑色,入隊 $2,3$ → $[2,3]$
出隊 $2$ 變黑色,入隊 $4,5$ → $[3,4,5]$
出隊 $3$ 變黑色,$5$ 已灰 → $[4,5]$
出隊 $4$ 變黑色,入隊 $6$ → $[5,6]$
出隊 $5$ 變黑色,$6$ 已灰 → $[6]$ → 結束。
由父節點可回溯到 $6$ 的最短路徑:$1!\to!2!\to!4!\to!6$(長度 $3$)。
為何最短——關鍵不變量:
當某頂點 $v$ 首次被發現時,$d[v]=d[u]+1$,其中 $u$ 是當下出隊的頂點,且 $d[u]$ 已是最小距離。
因為 BFS 以 FIFO 逐層擴張,所有距離 $<d[u]$ 的頂點早已出隊並掃完鄰邊;若存在更短路徑到 $v$,必從某個距離 $<d[u]$ 的頂點發現 $v$,與「$v$ 此刻才第一次被發現」矛盾。
因此 $d[v]$ 等於從 $s$ 到 $v$ 的最短邊數距離。
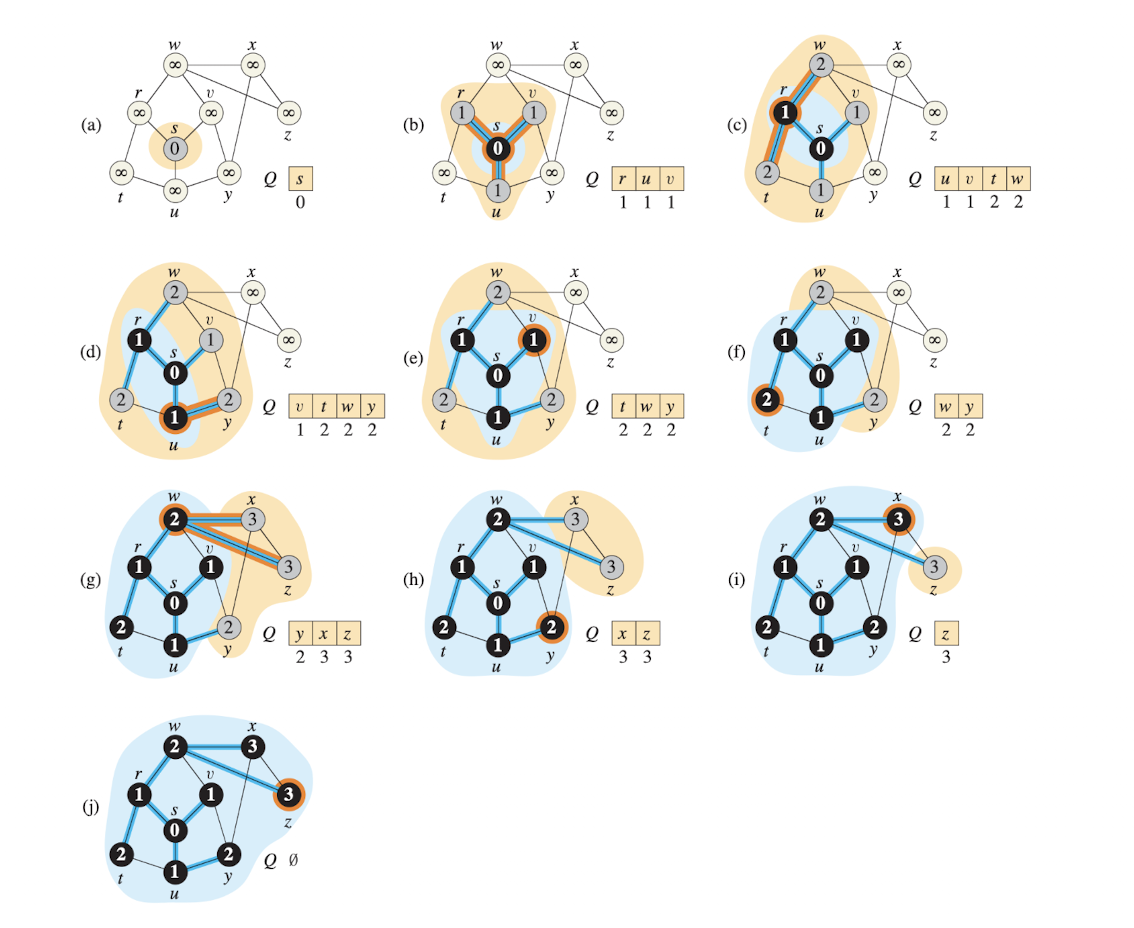
BFS 證明正確性
-
Lemma 20.1(相鄰差至多 1)
-
命題:對任一邊 $(u,v)$,$\delta(s,v)\le \delta(s,u)+1$。
-
解讀:有向圖僅在 $u\to v$ 時適用;無向圖兩向皆有,得 $|\delta(s,u)-\delta(s,v)|\le 1$。
-
一句證明:
$$
\begin{aligned} &\text{最短路 } s\to\cdots\to u \text{ 長 } \delta(s,u),\
&\text{接 }(u,v)\text{ 得一路徑長 } \delta(s,u)+1,\
&\Rightarrow\ \delta(s,v)\le \delta(s,u)+1\quad (\delta(s,u)=\infty\ \text{亦成立}).
\end{aligned}
$$ -
用途:保證 BFS 設新點距離時不會低估真實最短距離。
-
-
Lemma 20.2(上界)
-
命題:BFS 任一時刻(含結束),對所有 $v$ 有 $v.d\ge \delta(s,v)$。
-
基底:$s.d=0=\delta(s,s)$;對 $v\neq s$,$v.d=\infty\ge \delta(s,v)$。
-
歸納步(多行,用 align):
$$
\begin{aligned}
&\text{由 }u\text{ 發現白鄰 }v:\ v.d\leftarrow u.d+1,\
&u.d\ge \delta(s,u)\ \text{(歸納假設)},\
&\delta(s,v)\le \delta(s,u)+1\ \text{(Lemma 20.1)},\
&\Rightarrow\ v.d=u.d+1\ge \delta(s,u)+1\ge \delta(s,v).
\end{aligned}
$$ -
性質:$v$ 僅入隊一次且之後 $v.d$ 不變;因此 $\delta(s,v)\le v.d$,即 $v.d$ 是最短距離的上界。
-
-
Lemma 20.3(佇列性質)
-
命題:在 BFS 執行過程中,佇列 Q =
<v₁, ..., vᵣ>(v₁為首,vᵣ為尾)中的頂點距離滿足:-
$v_r.d \le v_1.d + 1$
-
$v_i.d \le v_{i+1}.d$,對 $i=1, \dots, r-1$(即佇列中頂點距離呈非遞減)
-
-
基底:初始時,佇列 Q 僅包含起點 s。此時 $r=1$,$v_1=s$。
-
條件 1:$v_1.d \le v_1.d + 1$,即 $0 \le 1$,成立。
-
條件 2:因 $r-1=0$,此條件無須檢驗,成立。
-
-
歸納步(證明此性質在「出隊」與「入隊」操作後依然保持),Dequeue 是在證明不可能超過$v_1.d+1$,那麼 Enqueue 是在證明,隊伍裡的牌是 $\ge$ 的排列:$$ \begin{aligned} &\text{1. 出隊 (Dequeue) 操作:}\ &\quad \text{設隊首 } v_1 \text{ 出隊,新隊首為 } v_2 \text{。}\ &\quad \text{由歸納假設:} v_1.d \le v_2.d \text{ 且 } v_r.d \le v_1.d + 1 \text{。}\ &\quad \text{將兩式合併:} v_r.d \le v_1.d + 1 \le v_2.d + 1 \text{。}\ &\quad \text{因此新佇列滿足性質。}\ \ &\text{2. 入隊 (Enqueue) 操作:}\ &\quad \text{設頂點 } u \text{ 剛出隊,其白色鄰居 } v \text{ 被加入佇列成新隊尾 } v_{r+1} \text{。}\ &\quad \text{此時 } v.d \leftarrow u.d + 1 \text{。}\ &\quad \text{由歸納假設,舊隊尾 } v_r \text{ 滿足 } v_r.d \le u.d + 1 \text{。}\ &\quad \Rightarrow v_r.d \le u.d + 1 = v_{r+1}.d \text{,非遞減性質保持。}\ &\quad \text{設目前隊首為 } v_1’ \text{,由歸納假設有 } u.d \le v_1’.d \text{。}\ &\quad \Rightarrow v_{r+1}.d = u.d + 1 \le v_1’.d + 1 \text{。}\ &\quad \text{因此新佇列滿足所有性質。} \end{aligned} $$
-
性質與直觀理解:此引理是 BFS 正確性的核心,它保證了演算法能夠「逐層」搜索。
因為佇列是先進先出 (FIFO),演算法一定會先把某一層(距離為 d)的節點全部處理完,才會開始處理下一層(距離為 d+1)的節點。在處理某一層節點時,會把下一層的新節點放到佇列的尾巴。這就導致了佇列中的節點距離最多只會橫跨兩層,因此隊尾的距離 $v_r.d$ 最多只會比隊首的距離 $v_1.d$ 多 1。
-
-
Corollary 20.4(入隊距離的遞增趨勢)
-
命題:
假設在 BFS 執行期間,頂點 $v_i$ 比頂點 $v_j$ 先被放入佇列 (enqueued)。則必然有 $v_i.d \le v_j.d$。
-
證明: $$ \begin{aligned} &\text{設 } u_i \text{ 與 } u_j \text{ 分別是 } v_i \text{ 與 } v_j \text{ 的父節點(發現者)。}\ &\text{則 } v_i.d = u_i.d + 1 \text{ 且 } v_j.d = u_j.d + 1 \text{。}\ \ &\text{因為 } v_i \text{ 比 } v_j \text{ 先入隊,這意味著 } u_i \text{ 的出隊時間早於或等於 } u_j \text{。}\ \ &\text{由 Lemma 20.3 可知,佇列隊首的 d 值總是佇列中最小的。}\ &\text{因此,演算法依序出隊的頂點序列,其 d 值是單調非遞減的。}\ \ &\text{因為 } u_i \text{ 早於或等於 } u_j \text{ 出隊,所以必然有 } u_i.d \le u_j.d \text{。}\ \ &\Rightarrow v_i.d = u_i.d + 1 \le u_j.d + 1 = v_j.d \text{。} \end{aligned} $$
-
性質:
此推論確保了 BFS 賦予頂點距離的過程是單調的。演算法探索的「前線」只會離起點越來越遠,絕不會後退。
-
-
Theorem 20.5(BFS 正確性)
-
命題:
當 BFS 演算法完成後,對於任何從起點 s 可到達的頂點 v,演算法計算出的距離 $v.d$ 等於真實的最短路徑距離 $\delta(s, v)$。此外,演算法建構的前驅子圖形成了一棵最短路徑樹。
-
證明 (使用反證法): $$\begin{aligned} &\text{1. 假設結論是錯的:}\ &\quad \text{假設存在至少一個頂點 v,使得 } v.d > \delta(s, v) \text{。}\ \ &\text{2. 選出關鍵的「第一個犯錯的點」v:}\ &\quad \text{在所有算錯的頂點中,令 v 為具有最小 } \delta(s, v) \text{ 值的那個點。}\ \ &\text{3. 找到 v 的「可靠證人」u:}\ &\quad \text{令 u 為 v 在某條真實最短路徑上的前一個頂點。}\ &\quad \text{因此 } \delta(s, v) = \delta(s, u) + 1 \text{。}\ &\quad \text{因為 } \delta(s, u) < \delta(s, v) \text{,且 v 是第一個犯錯的點,}\ &\quad \text{所以 u 的計算必定是正確的,即:} u.d = \delta(s, u) \text{。}\ \ &\text{4. 推導出矛盾的不等式:}\ &\quad v.d > \delta(s, v) \quad (\text{我們的初始假設}) \ &\quad \quad = \delta(s, u) + 1 \quad (\text{最短路徑的性質})\ &\quad \quad = u.d + 1 \quad (\text{因為 u 是可靠的})\ &\quad \Rightarrow \text{我們得到結論:} v.d > u.d + 1 \text{。}\ \ &\text{5. 戳破矛盾:}\ &\quad \text{當演算法處理到可靠的 u 時,它會檢查其鄰居 v。}\ &\quad \text{根據 BFS 的規則,v 的距離最多只會被設為 } u.d + 1 \text{。}\ &\quad \text{這與我們推導出的 } v.d > u.d + 1 \text{ 完全矛盾。}\ \ &\text{6. 結論:}\ &\quad \text{最初的假設不成立,因此對所有可達點 v,必有 } v.d = \delta(s, v) \text{。} \end{aligned} $$
-
性質與直觀理解:
這個定理是 BFS 演算法的最終保證書。整個證明就像一個偵探故事:透過假設有兇手(算錯的點),我們找到了第一個案發現場 (v),接著找到了案發前最後一個誠實的證人 (u)。結果證人的證詞 ($u.d$) 讓整個案件 ($v.d > \delta(s,v)$) 的邏輯完全無法成立,從而證明了兇手根本不存在。這確保了 BFS 那看似簡單的「逐層搜索」規則,確實能完美地找到最短路徑。
-
-
Lemma 20.6(最短路徑樹)
-
命題:
當廣度優先搜尋 (BFS) 應用於一個圖 G=(V, E) 時,其建構的前驅子圖 G_π = (V_π, E_π) 會形成一棵「廣度優先樹」。在這棵樹中,從起點 s 到任何可到達頂點 v 的路徑,都是圖 G 中的一條最短路徑。
-
證明 (核心思想): $$\begin{aligned} &\text{1. 前驅子圖 } G_\pi \text{ 的形成:}\ &\quad \text{根據 BFS 演算法,一個頂點 v 的前驅 } v.\pi \text{ 被設為 u,}\ &\quad \text{若且唯若 v 是在走訪 u 的鄰居時被首次發現的 (v.color == WHITE)。}\ &\quad \text{這表示除了起點 s,每個可到達的頂點都有一個「唯一的」父節點。}\ \ &\text{2. 證明 } G_\pi \text{ 是一棵樹:}\ &\quad \text{因為每個可達點 v (≠s) 都有唯一的父節點 } v.\pi \text{,}\ &\quad \text{從任何 v 開始反向追溯其父節點 (} v \to v.\pi \to \dotsb \text{),}\ &\quad \text{必然會形成一條回到根節點 s 的「唯一簡單路徑」。}\ &\quad \text{這個結構(單一根、無環、所有節點可達)正是一棵樹的定義。}\ \ &\text{3. 證明其為「最短路徑」樹:}\ &\quad \text{我們從 Theorem 20.5 已經知道,BFS 算出的距離是準確的:}\ &\quad \text{對所有 v,都有 } v.d = \delta(s, v) \text{。}\ &\quad \text{而 BFS 設定 } v.\pi = u \text{ 的同時,也設定了 } v.d = u.d + 1 \text{。}\ &\quad \text{將兩式結合可得:} \delta(s, v) = v.d = u.d + 1 = \delta(s, u) + 1 \text{。}\ &\quad \text{這完美符合最短路徑的性質。因此,樹上的每條路徑都是最短路徑。} \end{aligned}$$
-
性質與直觀理解:
這個引理完美地回答了您的問題:「所以我有一個點,我直接用他的 v.pi 一直往上找,就是他的最短路徑嗎?」
答案是:是的。
這個 Lemma 就是為這個操作提供了理論保證。它告訴我們,BFS 演算法不僅僅是算出一個個孤立的距離數字,它還留下了一張**「最短路徑地圖」**。這張地圖就是由所有的
π指標構成的樹。當你需要找出具體的路徑時,只要沿著這張地圖的指示(v.π)往回走,就一定能找到回家的最短的路。這也是PRINT-PATH函式能夠正確運作的根本原因。
-
BFS 正確性證明總表
| 引理/定理 | 一句話總結 (你的道理) | 核心數學式 / 結論 |
|---|---|---|
| Lemma 20.1 (圖的三角不等式) | 「走一步到鄰居,路程最多只會增加一」 | 對於任何邊 $(u,v)$, $\delta(s,v) \le \delta(s,u)+1$ |
| Lemma 20.2 (上界性質) | 「BFS 的估計,只會過長不會過短」 | 在演算法任何時刻, $v.d \ge \delta(s,v)$ |
| Lemma 20.3 (佇列性質) | 「隊伍裡的牌是 >= 的」,且 「也不可能超過 $v_1.d+1$」 |
對於佇列 Q=<v₁, ..., vᵣ>: 1. $v_r.d \le v_1.d + 1$ 2. $v_i.d \le v_{i+1}.d$ |
| Corollary 20.4 (單調性) | 「處理的順序,距離只會越來越遠」 | 如果 $v_i$ 比 $v_j$ 先入隊, 則 $v_i.d \le v_j.d$ |
| Theorem 20.5 (正確性) | 「既然是一層層來,那找到的一定是最短路」 | BFS 演算法是正確的, 最終對所有可達點 v, $v.d = \delta(s,v)$ |
一些應用
檢測是否是 Connected Graph
- 使用DFS or BFS追蹤圖型。完後,如果每一個頂點都 visited 過,則為connected。否則,unconnected。
- Time is $O(V+E)$ based on the adjacency lists representation
ConnectedComponent(G,n) //n is the number of vertex
{
	for i = 1 to n do visited[i]=false;
	for i = 1 to n do {
		if visited[i]==false {
			DFS(i); output the all newly visited vertex and edges;
			}
		 }
	 }
 }
計算連通分量
- 使用 CLRS DFS 也就是每次進一次回圈計算一次
// 主函式
Find_Connected_Components(Graph G):
  for each vertex u in G.V:
    u.color = WHITE
    u.parent = NULL

  time = 0
  component_count = 0

  for each vertex u in G.V:
    if u.color == WHITE:
      component_count = component_count + 1
      print("--- 連通分量 #", component_count, "---")
      DFS_Visit_and_Print(u)

// 遞迴輔助函式
DFS_Visit_and_Print(Vertex u):
  time = time + 1
  u.d = time
  u.color = GRAY

  print(u)

  for each vertex v in u.adj:
    if v.color == WHITE:
      v.parent = u
      DFS_Visit_and_Print(v)

  u.color = BLACK
  time = time + 1
  u.f = time
DETECT CYCLE
- 判斷流程:先分「有向」與「無向」。皆可用 DFS。時間 $O(V+E)$,空間 $O(V)。
directed graph
-
判斷依據:出現 back edge(遇到顏色 GRAY 的鄰點)即有環。
-
演算法流程
-
所有點設為 WHITE。
-
對每個 WHITE 節點做 DFS:進入時標 GRAY,離開標 BLACK。
-
掃鄰居 v:若 v 為 GRAY ⇒ 有環;若 v 為 WHITE ⇒ 遞迴 DFS(v)。
-
若整趟無 GRAY 邊 ⇒ 無環。
-
-
演算法(like C)
bool hasDirectedCycle(Graph g){
  enum {WHITE, GRAY, BLACK};
  int color[n]; fill(color, color+n, WHITE);

  bool dfs(int u){
    color[u]=GRAY;
    for(int v: g.adj[u]){
      if(color[v]==GRAY) return true;          // back edge
      if(color[v]==WHITE && dfs(v)) return true;
    }
    color[u]=BLACK;
    return false;
  }

  for(int u=0; u<n; ++u)
    if(color[u]==WHITE && dfs(u)) return true;
  return false;
}
undirected graph
-
原因:無向邊會被看兩次(u↔v)。用「看到 GRAY 就有環」會把「回到父節點」誤判,因此需排除父節點。
-
演算法流程
-
visited 全為 false。
-
對每個未訪問 u,呼叫 DFS(u, parent=-1)。
-
掃鄰居 v:
-
若未訪問 ⇒ DFS(v, parent=u)。
-
若已訪問 且 v ≠ parent ⇒ 有環。
-
若 v == parent ⇒ 忽略(反向邊)。
-
-
全部結束仍未觸發 ⇒ 無環。
-
-
演算法(like C)
bool hasUndirectedCycle(Graph g){
  bool vis[n]; fill(vis, vis+n, false);

  bool dfs(int u, int p){
    vis[u]=true;
    for(int v: g.adj[u]){
      if(!vis[v]) { if(dfs(v,u)) return true; }
      else if(v!=p) return true;              // back to non-parent
    }
    return false;
  }

  for(int u=0; u<n; ++u)
    if(!vis[u] && dfs(u,-1)) return true;
  return false;
}
- 備註(可選替代):無向圖也可用並查集(Union-Find)。掃每條邊 (u,v):若 find(u)=find(v) ⇒ 有環;否則 union(u,v)。時間 O(E α(V))。
level order BFS
- 簡單來說就是把 order 每層都輸出,通常用在 tree or binary tree,那麼這個輸出的會是 preorder 的效果
// Level-order (BFS) on a binary tree
void level_order(Node* root) {
    if (!root) return;
    queue<Node*> q;
    q.push(root);
    while (!q.empty()) {
        Node* u = q.front(); q.pop();
        visit(u);                      // e.g., printf("%c", u->data);
        if (u->left)  q.push(u->left);
        if (u->right) q.push(u->right);
    }
}