Database Internals 閱讀筆記
Database Internals 閱讀筆記的重點整理。
OLTP 與 OLAP:OLTP(Online Transaction Processing)處理日常交易,著重高併發(Concurrency)、低延遲(Low Latency)、短交易(Short Transactions)與 ACID。例如電商建立訂單、扣除庫存、記錄付款、查詢訂單狀態,會頻繁執行 INSERT、UPDATE、DELETE、SELECT,每筆交易通常只處理少量資料。OLAP 則著重資料分析,常涉及複雜 SELECT、JOIN 與聚合,單次查詢可能需要處理大量資料。
TPC-C 與 TPC-H:OLTP 是工作負載,TPC-C 則是衡量 OLTP 系統效能的 Benchmark。TPC-C 模擬批發商的訂單與庫存管理,混合執行 New-Order(建立訂單)、Payment(付款)、Order-Status(訂單狀態)、Delivery(出貨)與 Stock-Level(庫存水位)五種交易。
TPC-C 的指標為 tpmC(Transactions per Minute C)。例如 10,000 tpmC,表示在符合測試規範及其他交易負載條件下,每分鐘完成 10,000 筆 New-Order,不是所有 SQL 操作或交易加總後的 TPS。TPC-C 成績高,也不代表所有實際應用都比較快。OLAP 的複雜查詢與分析效能則可透過 TPC-H、TPC-DS 等 Benchmark 評估。
In-Memory DBMS 與持久化:In-Memory DBMS 主要直接存取 RAM 中的資料,但仍需要將資料持久化到 Disk,例如建立 Backup Copy、Snapshot 與保存 Log。相關背景處理可以採非同步(Async)方式,與 Client 的請求處理解耦(Decouple)。
例如 DB 在 10:00 有 1,000 筆資料,10:05 建立 Snapshot 並存入 Disk,10:06 又新增 100 筆資料,並將變更記錄到持久化日誌中。如果 DB 在 10:07 故障,重新啟動後,就先載入 10:05 的 Snapshot,再依序重播之後的 Log,恢復新增的資料。Snapshot 保存某個時間點的資料狀態,Log 記錄後續變更;Checkpoint 則與復原時從哪個進度繼續處理有關,具體方式依儲存引擎而定。
Row-Oriented 與 Column-Oriented:Row-Oriented 以資料列為單位組織資料,例如將同一個人的 ID、Name、Phone No. 放在一起。MySQL、PostgreSQL 常見的資料表採這類方式,適合一次取得一筆資料的多個欄位;但只查詢其中一個欄位時,讀取的 Block 可能也包含用不到的欄位,增加資料讀取量。
Column-Oriented 則把同一個欄位的值放在一起。例如 Name Column 為 Walle、John、Mary,Age Column 為 22、25、21,相同位置對應同一筆資料,可以用 Virtual ID 與 Array 的概念理解:Name[0] = Walle,Age[0] = 22。執行 SELECT AVG(age) FROM USER 時,只需要處理 Age 欄位,因此這類配置適合欄位掃描與聚合分析,也常用於涉及 JOIN 的分析工作負載。
Wide-Column Store:以 Row Key 為核心,透過 Column Family 組織大量且可能稀疏的欄位。它與 Column-Oriented 的分類重點不同:前者著重 Row Key 與 Column Family 的資料組織,後者著重同一欄位的值如何儲存與讀取。
SSD、GC 與 FTL Remapping:SSD 以 Page 為單位寫入,以整個 Block 為單位擦除,因此需要 GC(Garbage Collection)整理空間。例如 P1 存放 A、P2 存放 B,當 A 更新為 A′ 時,可以將 A′ 寫到新的 P3,原本的 A 則成為舊版本。
FTL 負責邏輯與實體位置的映射,例如 Logical Page 100 對應 Physical Block 5 的 Page 2。當資料更新或搬移,實體位置可能改變,FTL Remapping 會調整對應關係,讓 OS 不需要追蹤資料實際搬到哪裡。這裡的 SSD Page,與資料庫管理的 Database Page、虛擬記憶體使用的 OS Memory Page,屬於不同層次。
Index-Organized Table 與 Heap File:Index-Organized Table 將實際 Record 放在索引的 Leaf Node,沿著 B+ Tree 找到 Leaf Node 就能取得資料。Heap File 則將資料與索引分開,索引的 Leaf Node 保存 Record Location,再透過這個位置找到 Data Block 中的 Record。
Clustered Index 與 Non-Clustered Index:Clustered Index 依索引順序組織資料本身,一個 Table 最多有一個。Non-Clustered Index 則額外維護查找結構,透過索引定位資料,必要時回表取得完整資料。
例如 Users 依 ID 排列為 Amy(ID 1)、Walle(ID 2)、John(ID 3),查詢 ID BETWEEN 1 AND 3 時,可以沿 ID 順序取得資料。若再建立依 Name 排序的索引,順序就變成 Amy、John、Walle,索引項目分別指向 ID 1、3、2,提供另一條查找路徑。
Secondary Index(次級索引):讓查詢能使用 Primary Key 以外的欄位,例如透過 Email 找 User。依儲存方式不同,Secondary Index 可能直接保存資料列位置,也可能保存 Primary Key,先取得 Key,再查 Primary Index 才能拿到完整資料。這也說明了為什麼透過索引找到項目後,有時仍需要額外回表。
B+ Tree 與 LSM-Tree:B+ Tree 使用有序的結構,常見實作傾向於原地更新 Page;LSM-Tree 則先利用記憶體 Buffer 接受寫入,再透過不可變(Immutable)的磁碟檔案與 Compaction 整理資料。Append-Only、Copy-on-Write 都涉及把新版本寫到新位置的思路,但具體更新方式仍取決於儲存引擎。B+ Tree 的高 Fanout 可以降低樹高,減少查找需要經過的節點,進而降低可能發生的 Disk I/O。
Database Page 與 OS Page Cache:資料庫從 B+ Tree 取得 Page ID 後,需要先定位檔案中的位置,再把需要的資料讀進記憶體。以 Linux 使用一般 buffered pread() 的情況為例,OS 會先檢查 Page Cache,已有快取就能使用;沒有快取時,通常需要從 Disk 讀入,再將資料複製到資料庫的 User-Space Buffer。
假設 Database Page 為 8 KiB(8192 Bytes),OS Memory Page 為 4 KiB(4096 Bytes),且 Page ID 從 0 開始、資料頁在檔案中連續排列。讀取 Database Page 5 時,File Offset 為 5 × 8192 = 40960 Bytes,也就是 0xA000。這個 8 KiB 的資料頁涵蓋 OS File Page 10、11,檔案範圍分別為 0xA000–0xAFFF、0xB000–0xBFFF。一個 Database Page 可以涵蓋多個 OS Pages,載入後對應的實體記憶體也不必連續。
Virtual Memory、TLB 與 Page Table:資料庫同樣使用虛擬記憶體。Page Cache 查找的是檔案內容是否已在 RAM,TLB 則快取 Virtual Page 到 Physical Frame 的位址映射。兩者雖然都涉及 Page,處理的問題不同;CPU 在核心態存取 Page Cache、複製資料,以及在使用者態存取 Database Buffer 時,都涉及虛擬位址轉換。
延續上例,假設 Database Buffer 的起始虛擬位址為 0x7F0010000000,要讀取 Buffer 內偏移 4660 Bytes 的欄位。4660 的十六進位是 0x1234,因此該欄位的 Virtual Address 為 0x7F0010001234。這個 Offset 是示範值,並不是 B+ Tree 固定的欄位位置。
OS Page Size 為 4096 Bytes,也就是 2¹² Bytes,因此位址低 12 bits 是 Page Offset。4660 = 4096 + 564,表示資料位於 Buffer 的第二個 OS Page,距離該 Page 開頭 564 Bytes(0x234);Virtual Page Number 則為 0x7F0010001。
CPU 使用這個 Virtual Page Number 查 TLB。若 TLB Hit,就直接取得 Physical Frame;若 TLB Miss,則需要查 Page Table。假設查到的 Physical Frame 起始位址為 0x009A7000,加上 Page Offset 0x234,得到 Physical Address 0x009A7234。有效映射可以快取到 TLB,供後續存取使用。
Page Cache Miss、TLB Miss 與 Page Fault:Page Cache Miss 表示檔案內容沒有快取,通常需要讀取 Disk;TLB Miss 表示沒有快取位址映射,需要查 Page Table;Page Fault 則表示目前頁表映射無法直接滿足存取,需要 OS 處理。**TLB Miss 不等於 Page Fault,也不等於 Page Cache Miss,更不代表一定需要 Disk I/O。**例如 mmap() 的檔案頁若已在 Page Cache,可能只需要 Minor Page Fault 建立映射;若還必須從儲存裝置讀入,則可能涉及 Major Page Fault。
資料庫層處理 Page ID 到 File Offset,Page Cache 處理檔案內容的快取,Virtual Memory 則處理 Virtual Page 到 Physical Frame。把這三層分開,才能理解從 B+ Tree 找到 Page,到 CPU 實際存取資料之間的流程。
B-Tree Complexity:以 M 表示資料總數(Total Data Number)、k 表示 Fanout、h 表示 Tree Height,可以用以下關係理解樹高:
延伸閱讀:M-Way Search Tree 與 B-Tree。
B+ Tree 的 Leaf Links:典型的 B+ Tree 會把相鄰 Leaf Nodes 串接起來,讓範圍查詢先沿樹找到起始 Leaf,再沿葉節點連結依序讀取後面的資料,不必反覆回到父節點尋找下一頁。這主要用來提高範圍查詢與順序掃描的效率;只有 Leaf Nodes 相連,並不足以判定這是一棵 B-link Tree。
B-link Tree 的 Right Links 與 High Key:B-link Tree 在 B-tree/B+ Tree 的結構上加入同層節點的 Right Sibling Link,並配合 High Key 標示頁面範圍,這個機制也涵蓋 Internal Nodes。它的關鍵用途是處理並行搜尋與節點分裂:即使父節點尚未更新,搜尋仍可能先落到分裂前的舊頁面,再藉由 High Key 判斷目標已超出範圍,沿 Right Link 找到新的右側頁面。
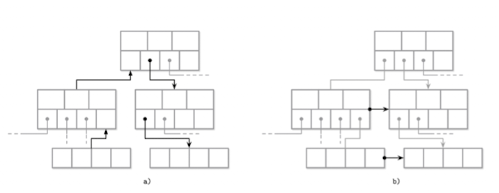
因此,B+ Tree 的葉節點串接與 B-link Tree 的橫向連結可以同時存在,不能只靠「有沒有兄弟連結」區分。圖中的 Internal Nodes 也有橫向連結,應搭配 B-link Tree 的機制理解,而不只解釋成葉節點的範圍掃描。PostgreSQL 採用 Lehman–Yao 的 B-link Tree 思路,並在各層維護左右兄弟連結。
Rightmost Pointer(最右側子節點指標):Internal Node 有 N 個分隔 Key,就需要 N+1 個 Child Pointers,因為 N 個 Key 將搜尋範圍分成 N+1 段。例如只有 10、20 兩個 Key,仍需要三個 Child Pointers,而不是三個 Key。依圖中的邊界慣例,三段分別是小於 10、大於等於 10 且小於 20,以及大於等於 20。
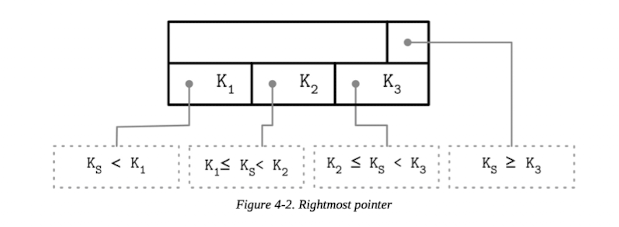
圖中的 Kₛ 是 Search Key,也就是正在查找的值;它用來與 K₁、K₂、K₃ 比較,決定走哪一個 Child Pointer,並不是額外放到最右側的 Key。當 Kₛ 大於等於 K₃,就沿 Rightmost Pointer 往下查找。頁面內可以把每個 Key 與左側 Child Pointer 放進同一個 Cell,再把多出來的最右側 Pointer 獨立存放在 Header 中。
SQLite 就採用這種將 Rightmost Pointer 獨立存放的配置:Interior B-Tree Page 的 Header 在 Offset 8 保存一個 4 Bytes 的最右側子頁面編號,Leaf Page 則沒有這個欄位。不過相等值的路由慣例要分開看:SQLite 官方描述的是左側子樹包含小於等於分隔 Key 的值,右側子樹包含大於分隔 Key 的值,因此不能直接套用圖中的所有不等號。
Rightmost Pointer 與 High Key 的配對:假設 Internal Node 有 20、50 兩個分隔 Key,以及 P₀、P₁、P₂ 三個 Child Pointers。採用左閉右開的範圍慣例時,P₀ 負責小於 20 的子樹,P₁ 負責 20 ≤ Key < 50,P₂ 則負責 Key ≥ 50。例如查詢 30,因為 20 ≤ 30 < 50,所以沿 P₁ 向下查找。P₂ 稱為 Rightmost Pointer,是因為它指向目前節點最右側的子樹。
如果把每個 Pointer 與其搜尋範圍的上界配對,就會得到(P₀, 20)、(P₁, 50),但 P₂ 在目前節點內沒有下一個一般分隔 Key 可以配對。這不代表它的範圍一定無限延伸;非根節點的整體範圍仍受到祖先節點的分隔條件限制。
假設目前節點管理的範圍上界為 80,可以將這個上界記為 High Key = 80。在把最右側 Child Pointer 與節點 High Key 放進同一個 Cell 的配置中,三個 Cell 就能統一表示為 (P₀, 20)、(P₁, 50)、(P₂, 80)。其中 P₂ 對應的範圍為 50 ≤ Key < 80;所有子樹也都受到目前節點整體下界的限制。
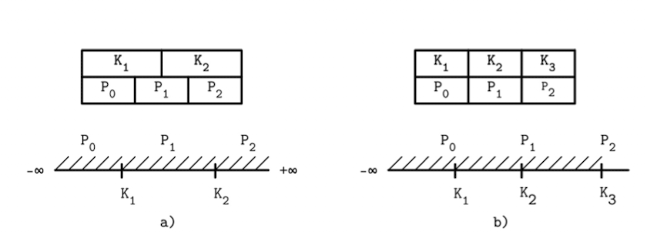
圖 a 的 K₁、K₂ 將範圍切成三段,分別由 P₀、P₁、P₂ 指向對應子樹;P₂ 在這個節點內沒有額外的 Key 標示上界,圖中以 +∞ 表示。圖 b 則加入 K₃ 作為目前節點的 High Key,讓最右側的 P₂ 也有明確的範圍上界,可以和 K₃ 放在同一個 Cell。K₃ 並沒有增加第四個 Child Pointer,而是為原本的最右側子樹補上上界。
一般分隔 Key 與 High Key:20、50 用來區分目前節點內不同子樹的搜尋範圍;80 則表示整個目前節點的範圍上界。在上述配置中,High Key 同時提供最右側子樹的上界,讓 P₂ 也能採用與其他 Child Pointers 相同的 Cell 格式,不必另外保留獨立的 Rightmost Pointer 欄位。這是另一種頁面配置選擇,與前面 SQLite 將 Rightmost Pointer 獨立存放在 Header 的方式不同。
High Key 與 Right Sibling Pointer:延續 High Key = 80、上界不包含 80 的假設,搜尋 90 時,因為 90 ≥ 80,表示目標已超出目前節點的範圍。在 B-link Tree 中,可以沿 Right Sibling Pointer 前往同一層右側的兄弟節點,繼續尋找目標所屬的範圍。
**Rightmost Child Pointer 是向下走,Right Sibling Pointer 則是向右走。**前者指向目前節點最右側的子樹,後者指向同一層的相鄰節點。High Key 的用途是標示節點範圍;把它與 Rightmost Child Pointer 配成一個 Cell,是利用這個上界統一儲存格式,並非 High Key 必須依賴這種配對才能存在,也不是所有 B-link Tree 都必須使用相同的實體配置。此處的比較條件沿用範例的左閉右開慣例,實作時仍須依資料庫對邊界相等值的規則判斷。
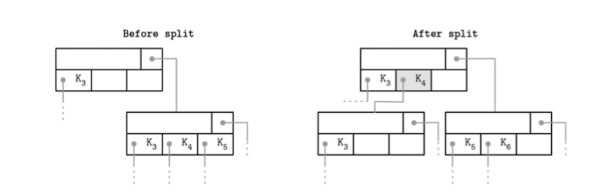
Split 與 Rightmost Pointer 更新:圖中右側子節點分裂後,原本的一個 Child 變成兩個,父節點需要加入分隔 Key K₄,以及對應的 Child Pointer。父節點原本的最右側路徑也要調整,讓 Rightmost Pointer 指向分裂後最右邊的新節點,其他搜尋範圍則由相應的 Cell 引導。
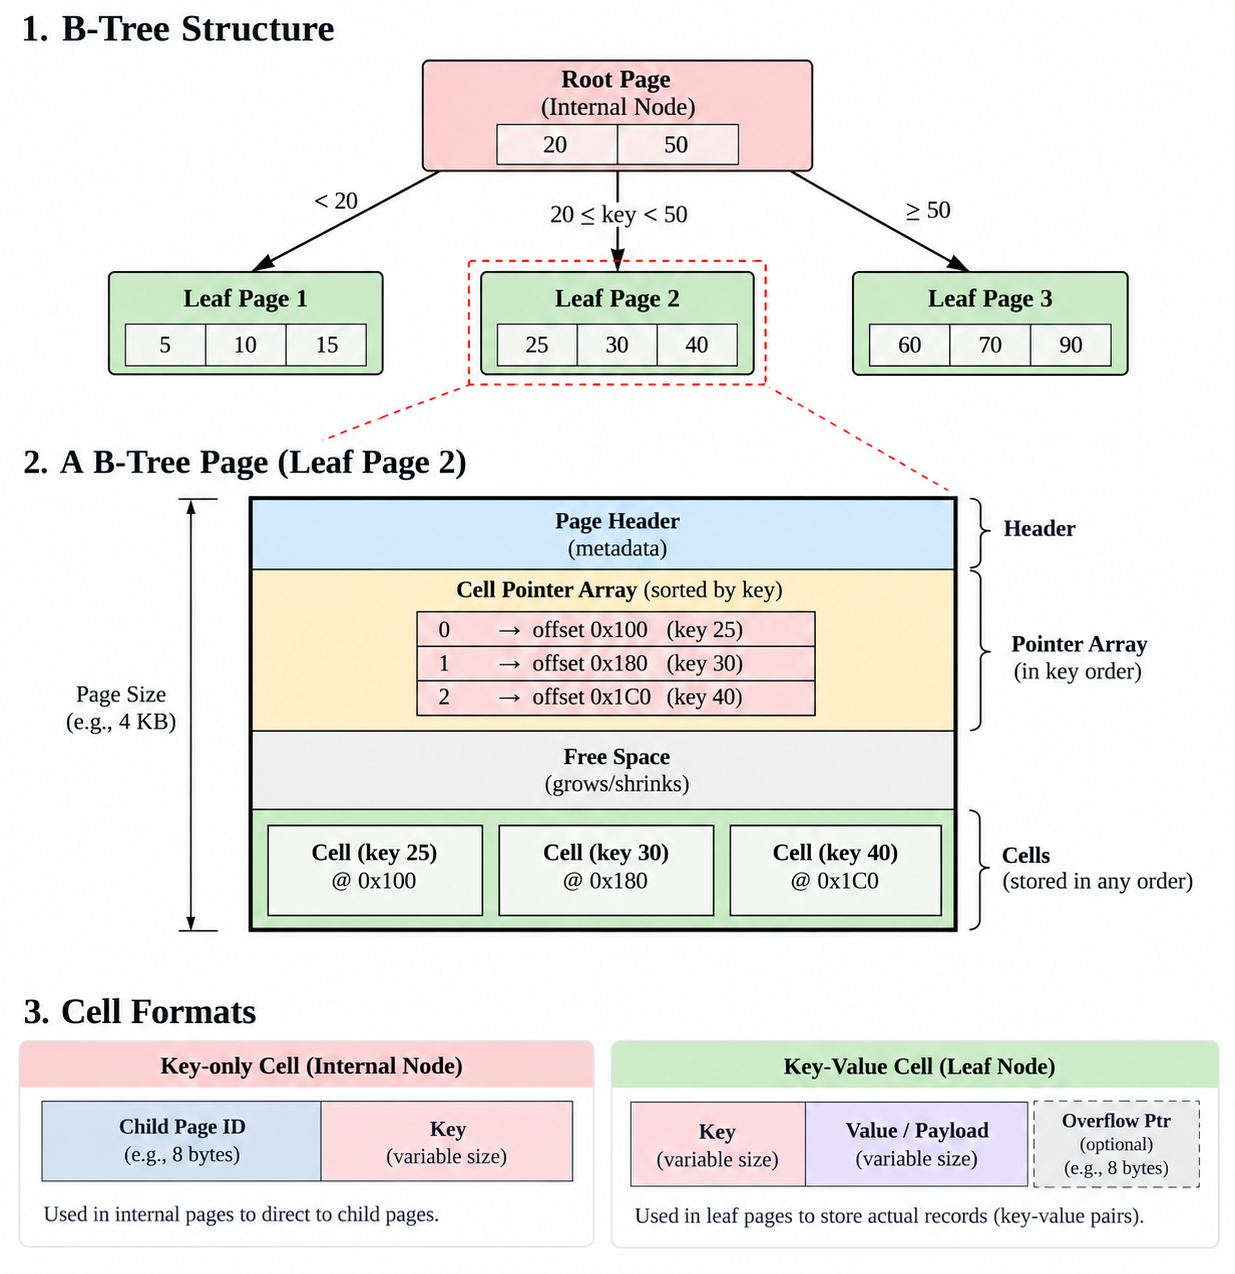
Magic Number:用來確認這是什麼格式的檔案。
Slotted Page:Page 由 Header、Slot Directory、可用空間與 Cells 組成。Slot Directory 中的每個 Slot 儲存 Offset,指向 Page 內對應的 Cell。圖中的 Pointers 就是這些 Slot;虛線表示它們與 Cells 的對應關係,Slot 的排列順序不必與 Cells 的實際存放順序相同。
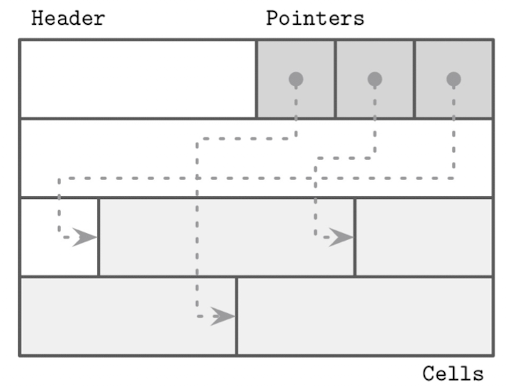
透過 Slot 間接定位資料,Page 內整理空間、移動 Cell 時,可以更新對應的 Offset,不必讓 Slot 跟著 Cell 一起移動。可用空間與 Cells 的位置由 Page 的配置管理。
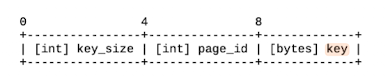
Key Cell:用於 Non-Leaf Node,包含 Key Size(4 Bytes)、Page ID(4 Bytes)與 Key(N Bytes)。圖上方的 0、4、8 表示各欄位相對於 Cell 開頭的 Byte Offset;Key 從 Offset 8 開始,長度由 Key Size 決定。Page ID 用來定位對應的子頁面。
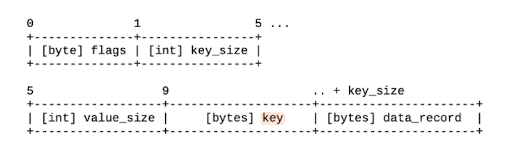
Key-Value Cell:用於 Leaf Node,包含 Flags(1 Byte)、Key Size(4 Bytes)、Value Size(4 Bytes)、Key(N Bytes)與 Data Record(M Bytes)。Flags 從 Offset 0 開始,Key Size 從 1 開始,Value Size 從 5 開始,Key 從 9 開始,Data Record 則從 9 + Key Size 開始。圖中分成兩行是為了排版,仍表示同一個 Cell 內連續的欄位配置。
Overflow Pages:B-Tree 的 Node 通常以固定大小的 Page 儲存,但每個 Record 的 Payload 可能是變長的(Variable-Size Payload)。因此,Key 數量尚未達到概念上的上限,不代表 Page 還有足夠的 Free Space;少數幾筆很大的 Record,就可能先把 Page 的位元組空間用完。實際上,對變長資料而言,Node 能容納多少 Key 也會受到每個 Cell 大小的影響,不能只看 Key 的數量。
當單筆 Record 太大,可以將部分 Payload 保留在 Primary Page,超出的部分放到 Overflow Page,再由原本的 Cell 透過 Pointer 找到剩餘內容。這樣就不必單純因為一筆 Record 太大,而把它全部擠在同一個 B-Tree Node 裡;即使進行 Node Split,也不一定能解決單筆 Record 本身大於 Page 可容納空間的問題。
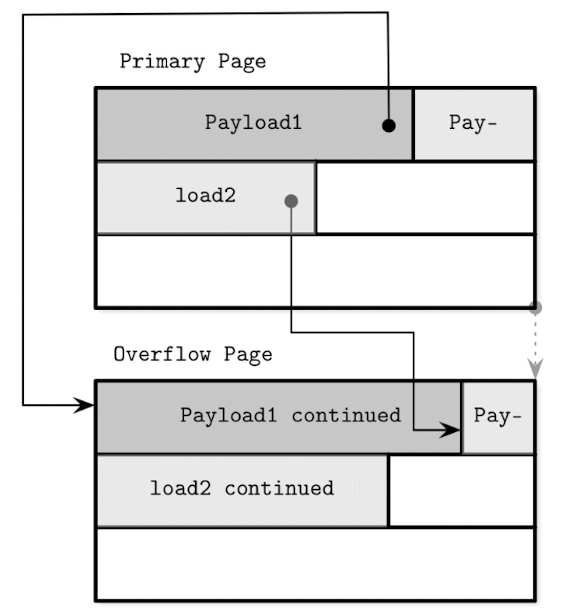
圖中的 Payload1、Payload2 都有一部分留在 Primary Page,其餘部分延伸到 Overflow Page。若額外內容仍放不下,多個 Overflow Pages 可以透過 Page ID 串接成 Linked List,每頁記錄下一個 Overflow Page 的位置,讀取完整 Record 時再沿連結取得後續 Payload。
max_payload_size 可以用來表示單筆 Payload 允許直接存放在 B-Tree Node 內的大小上限,超出這個限制的部分改存到 Overflow Page。實際門檻、欄位名稱與保留在原頁面的大小,仍依儲存引擎的實作而定。
Overflow Page 與 Node Split 的用途不同:Overflow Page 延伸的是單筆 Record 的儲存空間,不是 B-Tree 的 Child Node,也不會直接增加樹高;Node Split 則是把索引節點的內容分配到兩個節點,並更新父節點的分隔 Key 與 Child Pointer。把大型 Payload 移到 Overflow Page 可以減輕原頁面的空間壓力,但若原頁面仍放不下新的 Cell 或索引項目,依然可能需要 Split。
Overflow Pages 的讀取成本與 BLOB Storage:Overflow Pages 解決的是 Variable-Size Payload 超過 Primary Page 可用空間的問題,但完整讀取大型 Record 時,需要額外存取 Overflow Pages,並沿 Page ID 逐頁追蹤(Pointer Traversal)。若相關頁面尚未快取在記憶體中,就可能增加 Disk I/O;即使已有快取,仍有走訪連結的處理成本。
當大量 Records 都具有大型 Payload 時,可以考慮專門的 BLOB(Binary Large Object)Storage,讓大型內容由適合的儲存機制管理,索引或主要 Record 則保留對應的識別資訊。是否採用獨立的 BLOB Storage,仍取決於資料庫本身的支援方式與讀寫需求。