B-Tree 變種:CoW、LMDB、WiredTiger、LA-Tree、FD-Tree 與 Bw-Tree
B-Tree 變種:CoW、LMDB、WiredTiger、LA-Tree、FD-Tree 與 Bw-Tree的重點整理。
TL;DR
B-Tree 變種是在交換成本:讓寫入更便宜,可能就要多付出查詢、合併或版本管理的成本,沒有一種設計適合所有工作負載。
- CoW/LMDB:複製受影響的頁面與必要路徑,保留讀者快照;代價是頁面複製與舊版本空間。
- WiredTiger:修改先進 Update Chain,讀取時選擇可見版本,再透過 Reconciliation 整理磁碟頁面。
- LA-Tree:更新先緩衝、批次下推;查詢需要處理尚未套用的更新。
- FD-Tree:寫入先進 Head,再批次合併到 Sorted Runs;Fence 加速查詢,Tombstone 延後實際刪除。
- Bw-Tree:用 Delta 與 CAS 支援 Latch-Free 更新,之後需處理 Delta Chains、Consolidation 與舊版本回收。
- Cache-Oblivious B-Tree:用 vEB Layout 改善不同尺度的搜尋區域性,並以 Packed Array 的空位支援插入;代價是空間預留與重新分配。
選擇時要一起看讀寫比例、延遲、交易與恢復需求;早期 Flash/SSD 的實驗結果,也需要在目前的硬體與工作負載下重新驗證。
頁面配置、Cell 與交易處理見 Database Internals 閱讀筆記,基本結構見 多路搜尋樹與 B-Tree。
B+ Tree:Leaf Links
典型的 B+ Tree 會把相鄰 Leaf Nodes 串接起來,讓範圍查詢先沿樹找到起始 Leaf,再沿葉節點連結依序讀取後面的資料,不必反覆回到父節點尋找下一頁。這主要用來提高範圍查詢與順序掃描的效率;只有 Leaf Nodes 相連,並不足以判定這是一棵 B-link Tree。
B-link Tree:Right Links 與 High Key
B-link Tree 在 B-tree/B+ Tree 的結構上加入同層節點的 Right Sibling Link,並配合 High Key 標示頁面範圍,這個機制也涵蓋 Internal Nodes。它的關鍵用途是處理並行搜尋與節點分裂:即使父節點尚未更新,搜尋仍可能先落到分裂前的舊頁面,再藉由 High Key 判斷目標已超出範圍,沿 Right Link 找到新的右側頁面。
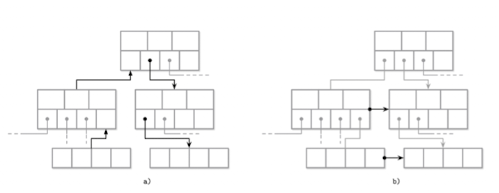
因此,B+ Tree 的葉節點串接與 B-link Tree 的橫向連結可以同時存在,不能只靠「有沒有兄弟連結」區分。圖中的 Internal Nodes 也有橫向連結,應搭配 B-link Tree 的機制理解,而不只解釋成葉節點的範圍掃描。PostgreSQL 採用 Lehman–Yao 的 B-link Tree 思路,並在各層維護左右兄弟連結。
High Key、最右側子指標與橫向連結
Rightmost Pointer 與 High Key 的配對:假設 Internal Node 有 20、50 兩個分隔 Key,以及 P₀、P₁、P₂ 三個 Child Pointers。採用左閉右開的範圍慣例時,P₀ 負責小於 20 的子樹,P₁ 負責 20 ≤ Key < 50,P₂ 則負責 Key ≥ 50。例如查詢 30,因為 20 ≤ 30 < 50,所以沿 P₁ 向下查找。P₂ 稱為 Rightmost Pointer,是因為它指向目前節點最右側的子樹。
如果把每個 Pointer 與其搜尋範圍的上界配對,就會得到(P₀, 20)、(P₁, 50),但 P₂ 在目前節點內沒有下一個一般分隔 Key 可以配對。這不代表它的範圍一定無限延伸;非根節點的整體範圍仍受到祖先節點的分隔條件限制。
假設目前節點管理的範圍上界為 80,可以將這個上界記為 High Key = 80。在把最右側 Child Pointer 與節點 High Key 放進同一個 Cell 的配置中,三個 Cell 就能統一表示為 (P₀, 20)、(P₁, 50)、(P₂, 80)。其中 P₂ 對應的範圍為 50 ≤ Key < 80;所有子樹也都受到目前節點整體下界的限制。
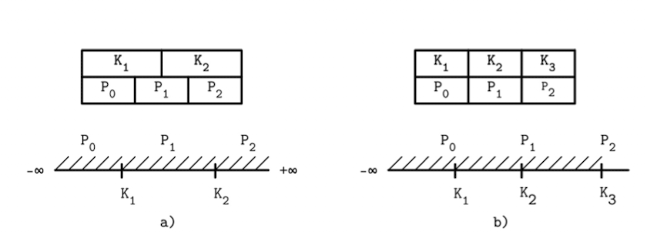
圖 a 的 K₁、K₂ 將範圍切成三段,分別由 P₀、P₁、P₂ 指向對應子樹;P₂ 在這個節點內沒有額外的 Key 標示上界,圖中以 +∞ 表示。圖 b 則加入 K₃ 作為目前節點的 High Key,讓最右側的 P₂ 也有明確的範圍上界,可以和 K₃ 放在同一個 Cell。K₃ 並沒有增加第四個 Child Pointer,而是為原本的最右側子樹補上上界。
一般分隔 Key 與 High Key:20、50 用來區分目前節點內不同子樹的搜尋範圍;80 則表示整個目前節點的範圍上界。在上述配置中,High Key 同時提供最右側子樹的上界,讓 P₂ 也能採用與其他 Child Pointers 相同的 Cell 格式,不必另外保留獨立的 Rightmost Pointer 欄位。這是另一種頁面配置選擇,與 Database Internals 中 SQLite 將 Rightmost Pointer 獨立存放在 Header 的方式不同。
High Key 與 Right Sibling Pointer:延續 High Key = 80、上界不包含 80 的假設,搜尋 90 時,因為 90 ≥ 80,表示目標已超出目前節點的範圍。在 B-link Tree 中,可以沿 Right Sibling Pointer 前往同一層右側的兄弟節點,繼續尋找目標所屬的範圍。
**Rightmost Child Pointer 是向下走,Right Sibling Pointer 則是向右走。**前者指向目前節點最右側的子樹,後者指向同一層的相鄰節點。High Key 的用途是標示節點範圍;把它與 Rightmost Child Pointer 配成一個 Cell,是利用這個上界統一儲存格式,並非 High Key 必須依賴這種配對才能存在,也不是所有 B-link Tree 都必須使用相同的實體配置。此處的比較條件沿用範例的左閉右開慣例,實作時仍須依資料庫對邊界相等值的規則判斷。
Copy-on-Write B-Tree
簡單來說,就是複製受影響的 Page,並複製、更新通往 Root 的必要路徑,其他未修改的頁面繼續共用;B-Tree 越淺,需要複製的路徑通常越短,舊頁則要等不再被讀者引用後才能重用。
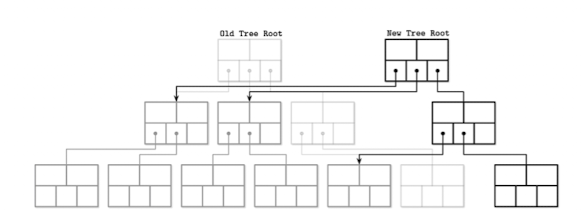
圖中 Old Tree Root 保留舊版本,New Tree Root 經由新複製的路徑指向修改後的 Leaf;未受影響的子樹仍由新舊版本共用,不需要複製整棵樹。
LMDB:MVCC 與 Copy-on-Write
LMDB(Lightning Memory-Mapped Database)是嵌入式 Key-Value 資料庫,使用 B+ Tree、Memory Mapping 與 CoW。MVCC 負責版本與交易可見性;LMDB 透過 CoW 保留讀者仍需使用的舊頁面,新寫入交易建立新的頁面版本,讀者便可繼續存取自己的 Snapshot。它支援多個讀取交易並行,但同一個 Environment 同時只允許一筆寫入交易。
LMDB 由 OpenLDAP 專案維護,可從 OpenLDAP 官方來源庫頁面找到 LMDB 專案,並參考 LMDB 官方文件;它是資料庫程式庫,不是 LDAP 協定本身。
Memory Mapping 與 OS 的分工:它把檔案映射到程式的虛擬位址空間,讓程式透過記憶體存取方式讀取資料,頁面的載入、映射與 OS Page Cache 管理由作業系統處理;資料庫仍須設計並行控制、版本發布、頁面重用與持久化順序。修改映射中的記憶體不等於資料已安全落盤,而且 LMDB 的預設模式不是透過可寫映射直接更新資料;MDB_WRITEMAP/writemap=True 是另一項選擇,不能與所有 LMDB 寫入流程畫上等號。參考 LMDB 官方文件。
WiredTiger:Update Chain 與 Reconciliation
WiredTiger 是儲存引擎;以其 B-Tree Row-Store 為例,修改會在葉頁面內為對應的 Key 建立或延伸 Update Chain,保存帶有交易/時間戳資訊的版本,讀取時依可見性選擇合適版本。它不是在每個 Internal Node 都放一個等待向下傳播的 Update Buffer;Update Chain 也不是 WAL,兩者分別處理記憶體版本與故障恢復所需的日誌。
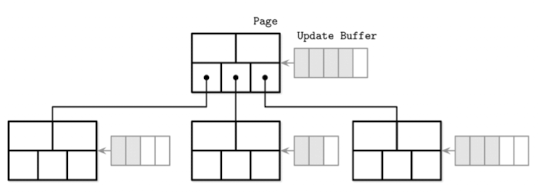
圖中以 Page 與 Update Buffer 示意緩衝修改的思路,不是實際記憶體結構的逐欄位配置;Row-Store 的資料版本更新鏈應依葉頁面中的 Key 理解,不能據圖推論每個 Internal Node 都有相同的資料版本鏈。參考 WiredTiger 官方:B-Trees。
WiredTiger 的 Clean Page、Dirty Page 與 Eviction:Page 從磁碟讀入快取後,讀取可以直接使用;新增修改後成為 Dirty Page,Commit 決定交易結果與版本可見性,不代表資料頁已寫回,所以已提交交易的頁面仍可能是 Dirty。Clean Page 在符合安全條件時可以直接移出快取;Dirty Page 則需透過 Reconciliation 等步驟妥善保存修改,再決定能否移出。WiredTiger 使用近似 LRU 的頁面選擇方式,實際 Eviction 也受頁面使用狀態、交易可見性與 Dirty Cache 壓力影響。參考 WiredTiger:Cache。
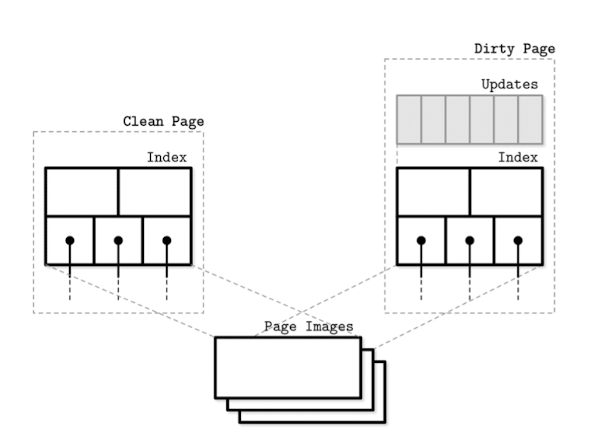
圖中的 Clean Page 與 Dirty Page 都有記憶體中的 Index,並對應磁碟上的 Page Images;Dirty Page 額外帶有尚待整合的 Updates,顯示記憶體結構與磁碟頁面映像可以不同。
WiredTiger 的修改、讀取與寫出流程:搭配上圖,可以分成三個重點理解:
- 修改先放到 Update Buffer/Update Chain:找到 Leaf Page 中對應的 Key,把新版本加入記憶體中的更新鏈,頁面成為 Dirty;不必每次修改都重寫磁碟上的整個 Page Image。
- 讀取時組合可見結果(Composition):需要讀取時,依交易 Snapshot 與可見性,從 Update Chain 或原始頁面中取得合適版本;若更新保存的是差異,還需要重建完整值,並不是把所有交易的修改一律相加。
- 寫出時做 Reconciliation(頁面整合):Checkpoint 或 Dirty Page Eviction 等流程需要寫出頁面時,把原始內容與適合寫出的更新整理成新的 Page Image,再寫到磁碟;仍需保留的歷史版本或尚不能移出的更新,則由 History Store、Update Restore 等機制處理。
簡單記成:修改先緩衝,讀取時選擇/組合可見版本,需要寫出時再整合成磁碟頁面;第二步是讀取路徑,第三步是寫出路徑,不是每次更新都必須依序走完三步。Commit 也不等於完成 Reconciliation 或已經寫回資料頁。參考 WiredTiger:Eviction 與 Reconciliation。
LA-Tree:子樹緩衝與批次下推
LA-Tree(Lazy-Adaptive Tree)把節點分成子樹,為子樹配置 Update Buffer,緩衝該子樹範圍的操作。新操作先進入 Root Buffer,滿了之後依 Key 範圍批次傳到下層子樹的 Buffer,下層再滿就繼續傳播,最後在 Leaf 批次套用 Insert、Update、Delete,降低零碎 I/O。它緩衝的是子樹範圍內尚待套用的操作,與 WiredTiger 葉頁面中個別 Key 的版本鏈不是相同層次;讀取也必須考慮尚未下推的更新。
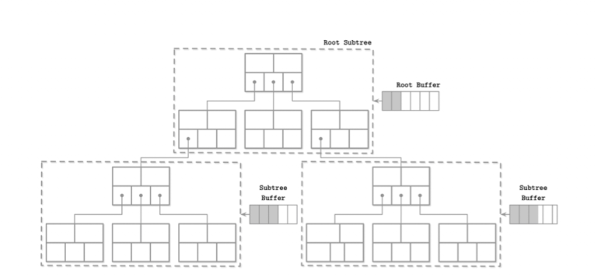
圖上方的 Root Buffer 管理 Root Subtree 的待處理更新,下方各個 Subtree Buffer 管理自己的 Key 範圍;灰色項目表示從上層傳下來的更新,緩衝滿時再批次繼續向下傳播,而不是每次修改都立即走到 Leaf 寫回。
子樹 Buffer 與版本鏈的組合:概念上可以,上層負責批次緩衝,下層負責版本保存;但讀取必須整合相關 Buffer 與葉節點版本,並處理操作順序、交易可見性、重複套用與故障恢復。這是一種可討論的組合設計,不能直接說它就是 WiredTiger 現有架構。
FD-Tree:Head Tree、Sorted Runs 與批次合併
FD-Tree 把更新先集中在小型 Head B+ Tree,再批次合併到容量逐層增加的 Sorted Runs,將許多零碎隨機寫入轉為較大的循序寫入;L1、L2 表示 Run 的層級,不是 Head B-Tree 內部的節點深度。這與 LSM-Tree 的分層合併思路相似,但不是 FD-Tree 啟發了 LSM:LSM-Tree 的經典論文發表於 1996 年,早於 FD-Tree。參考 LSM-Tree 原論文。
Fractional Cascading 與 Bridge/Fence:在相鄰有序陣列之間,將下層選定的 Key 與位置指標複製到上一層,建立可一路向下追蹤的路標,縮小每層需要重新搜尋的範圍。FD-Tree 依頁面邊界建立 Fences;本例把下層每頁的第一個 Key 複製到上層,附上該頁指標,不是搬走原資料,也不是把整個下層陣列拉到最高層。「縮小 Gaps」可理解為降低導航位置與目標之間的搜尋距離,不是讓頁面沒有空隙。
三階段範例:10 筆初始資料,再另外新增 15、35:假設 10、20、30、40、50、60、70、80、90、100 已放在 L2,每頁最多放 5 個項目;D 表示資料項目,F 表示帶有下一層頁面指標的 Fence。Fence 不算新增一筆邏輯資料,但仍占儲存空間與頁面容量;以下是說明資料與導航如何分工的簡化示例,不涵蓋完整 FD-Tree 的所有 Fence 維護細節。
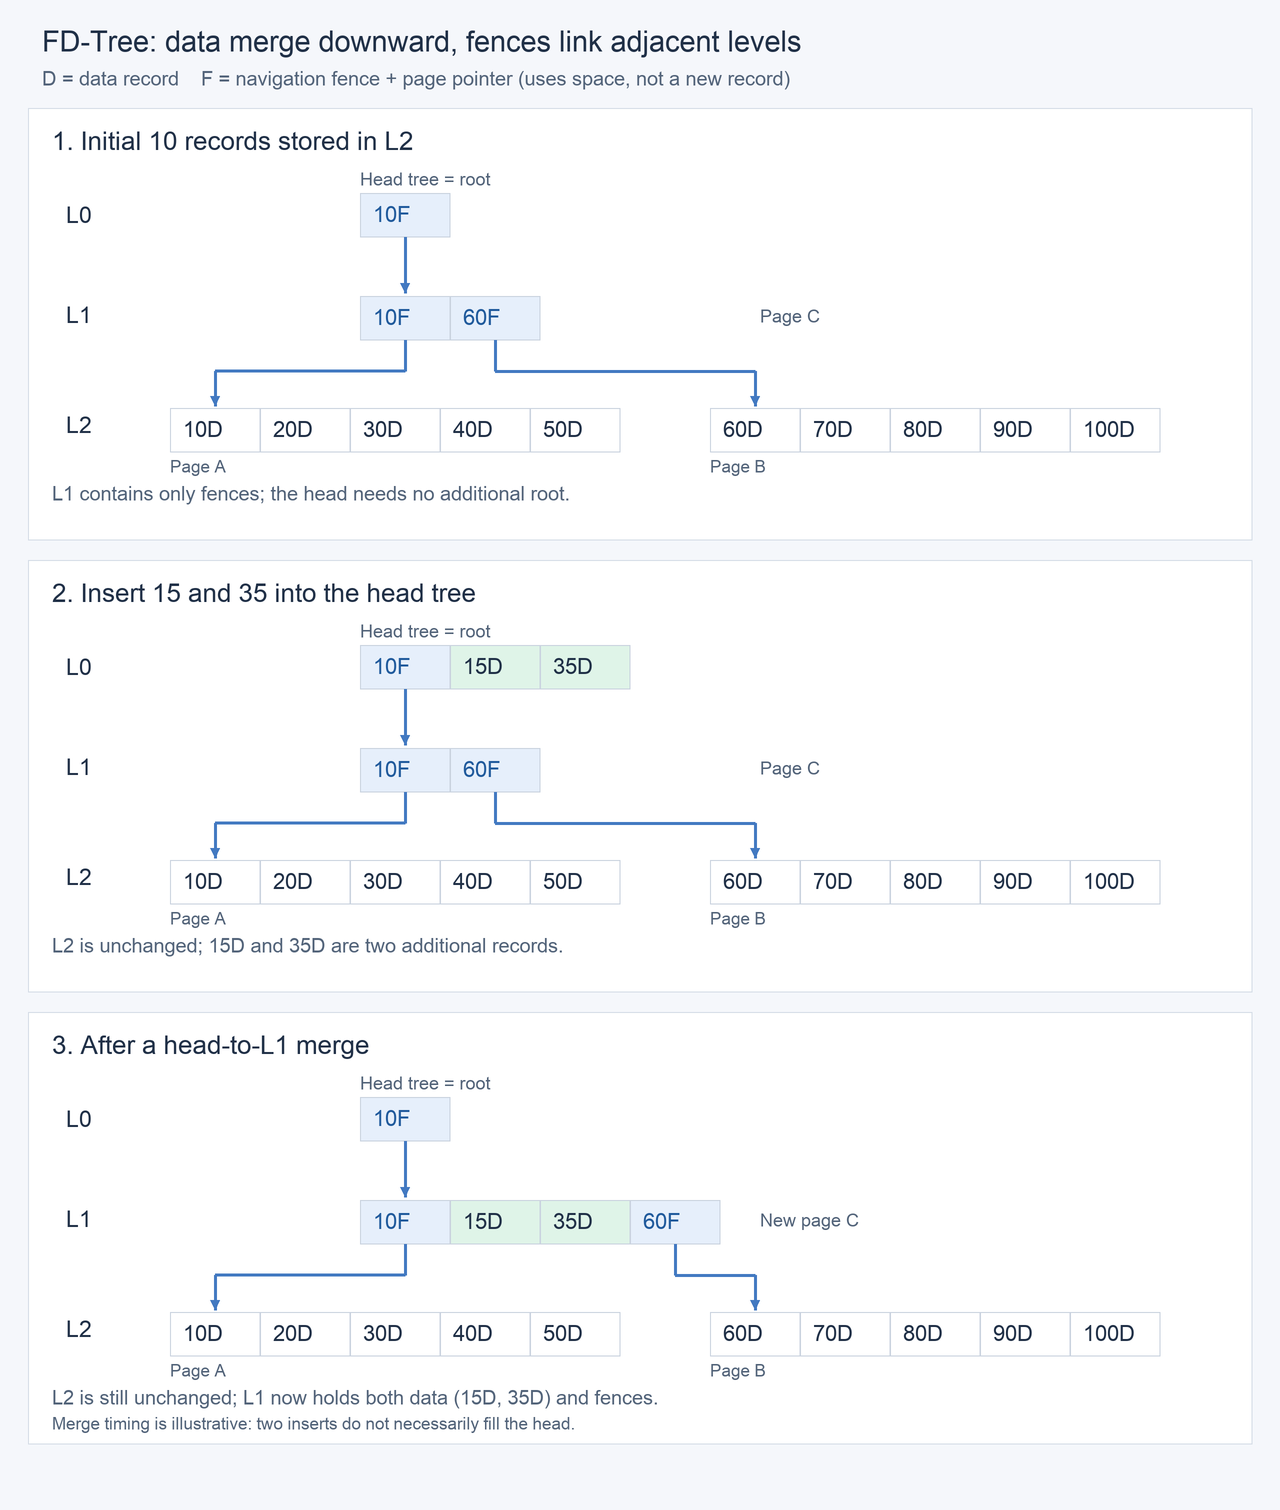
- 初始資料在 L2,向上建立路標:Page A 放
10D、20D、30D、40D、50D,Page B 放60D、70D、80D、90D、100D;因此 L1 的 Page C 放10F、60F,分別指向 A、B。L1 目前只有 C 一頁,所以 Head 只需10F指向 C;這個 Head 節點本身就是 Root,不需再憑空加一層 Root。L1 此時只有導航 Fences,沒有額外的資料項目。 - 另外新增 15、35,先進入 Head:Head 變成
10F、15D、35D;10F 仍指向 L1,15D 與 35D 是另外新增的兩筆資料,總資料數從 10 增為 12,原本 L2 的兩頁完全沒有改動。 - 達到合併條件後,Head 的資料合併到 L1:Head 達到設定容量時,便觸發與 L1 的合併;若合併結果超過 L1 的容量門檻,則繼續向 L2 合併。本例的「5 個項目」只是單頁容量,沒有另外指定 Head/各層的合併門檻,也不是下層頁面不足 5 筆就合併。將 15D、35D 與 L1 原有的 10F、60F 按 Key 合併,寫出新的 C,內容為
10F、15D、35D、60F,並更新 Head 的 10F 指標。L2 仍保持原狀,所以 L1 出現 L2 沒有的 15、35 完全合理:它們還沒有繼續合併到 L2。本例只示範合併結果,不表示插入兩筆就一定達到容量門檻。
查找 35 與 70:以上圖第三階段為例,查找 35 時,沿 Head 的 10F 到 L1,直接找到 35D;查找 70 時,沿 Head 到 L1,再選 60F 前往 L2 的 Page B,找到 70D。對落在兩個頁面起始 Key 之間的值,本例使用不大於搜尋值的適當 Fence 導航;一般查詢還需整合各層可能存在的資料與刪除標記。資料批次向下合併,導航路標則依下層頁面邊界向上建立,兩個方向不要混淆。
FD-Tree 是否就地更新?:Head Tree 是可更新的小型 B+ Tree;下層 Sorted Runs 則不為每筆修改直接覆寫原頁面,而是在合併時產生新的 Run 與頁面,再更新必要的導航資訊。因此應說「下層 Run 以批次合併取代逐筆就地更新」,不能說整個 FD-Tree 完全沒有任何就地修改。參考 FD-Tree 論文:Tree Indexing on Solid State Drives。
Tombstone:先記錄刪除,再於合併時消去舊資料:若要刪除 L2 的 70,不必立刻改寫 Page B;可以在 Head 插入代表刪除的標記。FD-Tree 論文稱這類標記為 Filter Entry,以原項目的 Key + Record ID 辨識刪除目標;下層尚未物理移除的舊項目稱為 Phantom Entry,這裡不是交易隔離中的 Phantom Read。本例假設 Key 唯一,可簡寫成 70T;T 表示 Tombstone,避免與圖中表示 Fence 的 F 混淆。
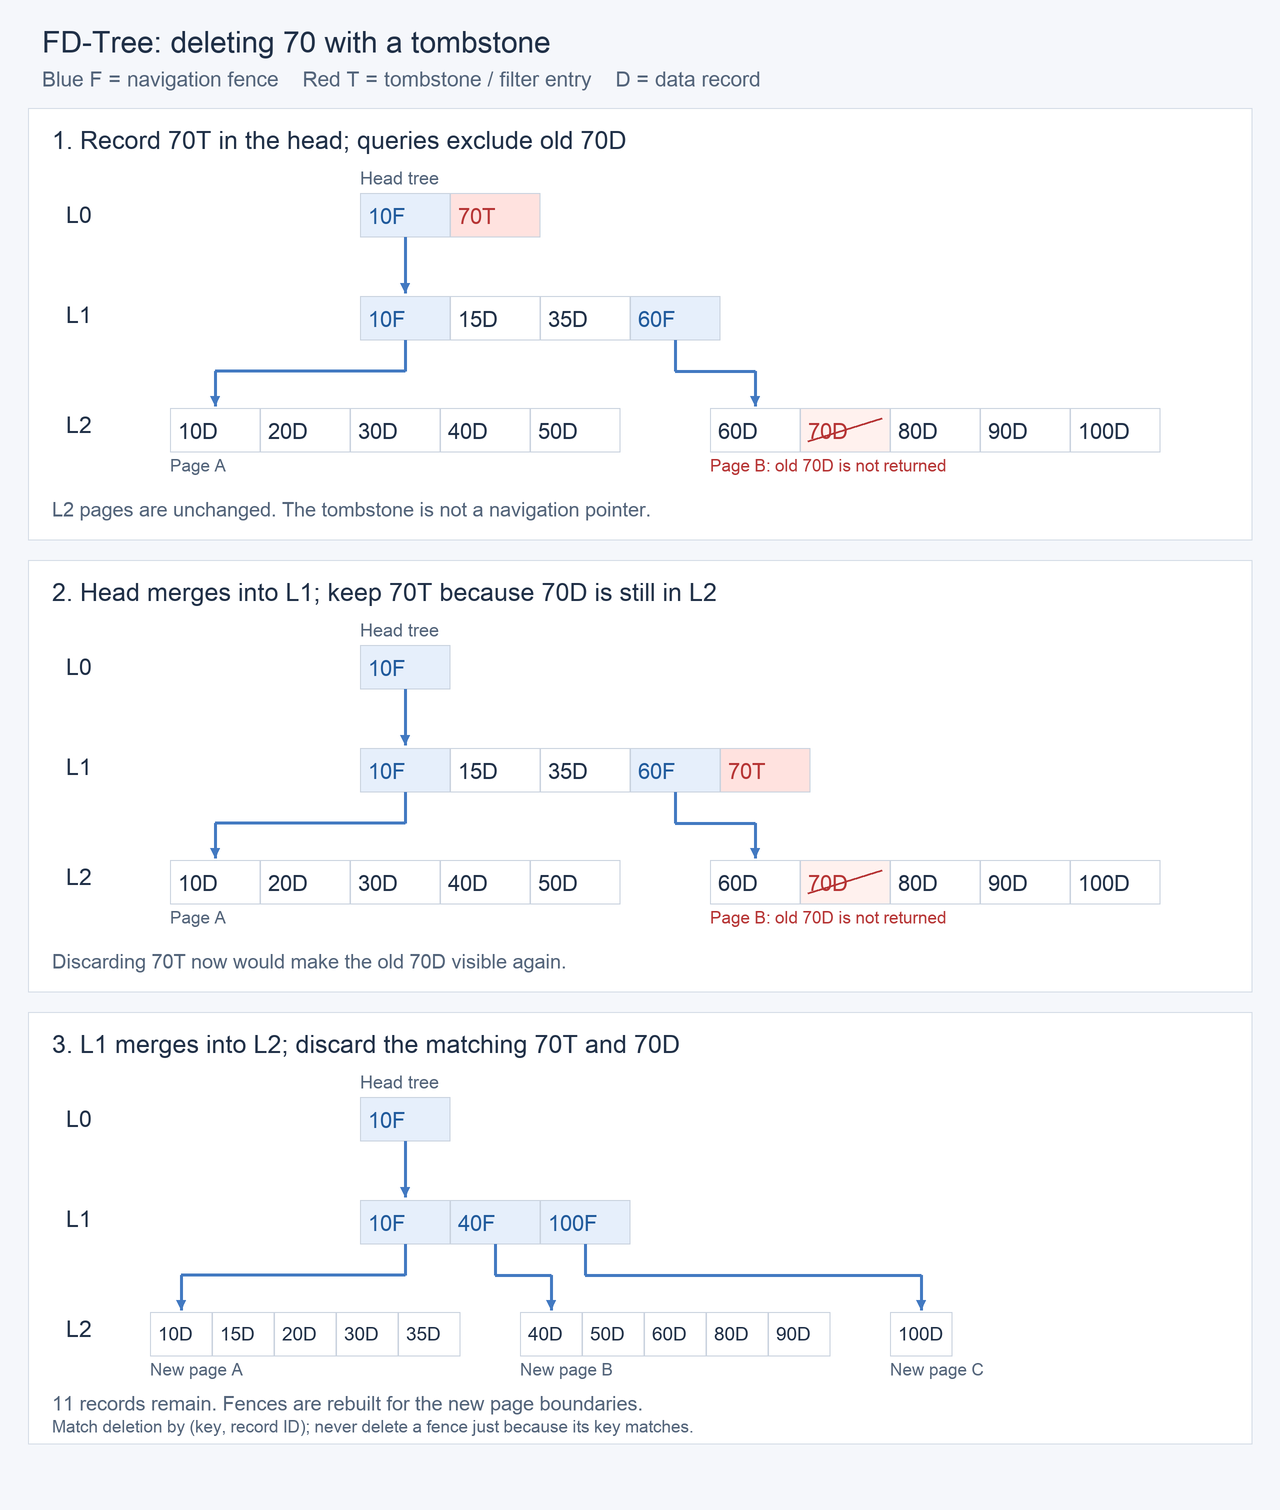
圖中接續前例新增 15、35 後的狀態,紅色 70T 是墓碑,劃線的 70D 是尚未物理移除、但查詢不可回傳的舊資料;最後合併後剩 11 筆資料,依每頁最多 5 個項目重新分頁,Fences 也隨新頁面邊界重建。藍色 Fence 只負責導航,不是刪除標記。
- 先在 Head 記錄刪除:要刪除 L2 的 70,就在 Head 加入 70T,原本 L2 的 70D 暫時保留,但邏輯上已被刪除;若目標本來就在 Head,論文允許直接從 Head 刪除。
- 查詢時排除舊資料:查找 70 時必須一起考慮刪除標記,不能看到 L2 還有 70D 就回傳;用對應的 Key/Record ID,將 Filter Entry 與已刪除的舊項目從有效結果中排除。
- Head 與 L1 合併時,墓碑移到 L1:此時舊 70D 還在 L2,因此 70T 必須繼續保留;若先丟掉標記,下次查詢可能又把舊 70 當成有效資料,造成資料「復活」。
- L1 與 L2 合併時,消去對應項目:70T 與它標記的舊 70D 相遇後,兩者一起丟棄,不再寫入新的 Run,完成索引項目的物理清除。論文也將 Update 實作為刪除舊項目,再插入新項目。
Fence 與 Tombstone 的差別:Fence/Bridge 告訴查詢「下一層要去哪一頁」,Tombstone/Filter Entry 則標記「哪個舊資料項目已被刪除」;刪除必須識別項目類型及 (Key, Record ID),不能刪除所有相同 Key 的項目,也不能把同 Key 的導航 Fence 一起消去。本例假設 70 只有一筆資料,才省略 Record ID,生命週期可以記成:先標記刪除,查詢排除舊資料,合併時配對清除。
Bw-Tree:Delta Chain、Mapping Table 與 CAS
Bw-Tree 將頁面修改表示為 Delta Records,接在各邏輯頁面的 Delta Chain 前端,避免每次都原地改寫整個頁面;記憶體中的 Mapping Table 則把 Logical Page ID 對應到該頁面最新的入口位置。更新時,先建立指向原入口的新 Delta,再用原子操作 CAS(Compare-and-Swap) 將對應入口換成新 Delta;若入口已被其他執行緒改變,CAS 就會失敗,更新者必須重新讀取狀態並依操作規則重試。當 Delta Chain 過長時,再透過 Consolidation,將累積修改與 Base Page 整合成新的 Base Page。
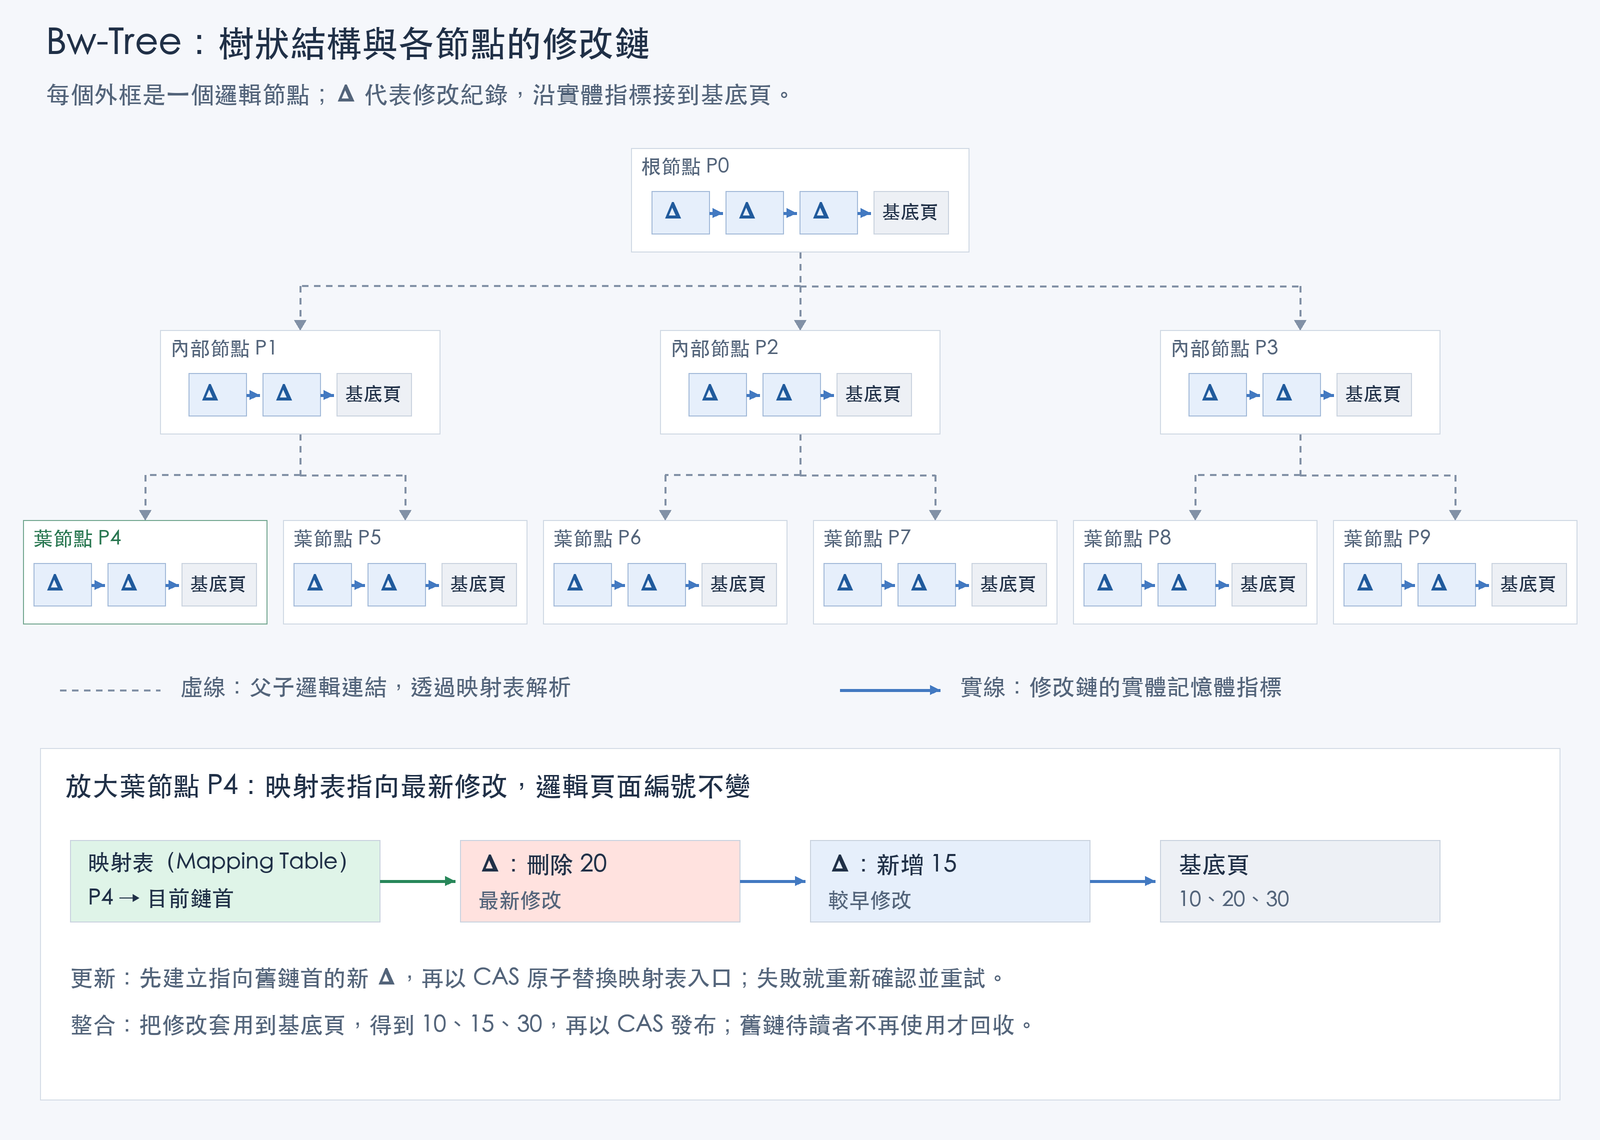
圖中分成 Root、Internal 與 Leaf 三層,每個邏輯節點都由 Delta Chain 與 Base Page 組成;虛線是經 Mapping Table 解析的父子邏輯連結,實線是修改鏈的實際記憶體指標。下方放大葉節點 P4,顯示映射表如何指向最新 Delta;最新修改在鏈首,Base Page 在鏈尾,更新入口時不需要因此一路改寫所有祖先的實體指標。
更新流程:
- 定位邏輯頁面:從 Root 往 Leaf 搜尋,經由 Mapping Table 將 Logical Page ID 解析為該頁目前的 Base Page 或最新 Delta。
- 建立新 Delta:把這次修改記錄成 Delta Record,並讓它指向剛讀到的原入口,不直接改動舊 Base Page 或既有 Delta Chain。
- 以 CAS 發布更新:只有 Mapping Table 的入口仍等於預期舊值時,才原子替換為新 Delta;若失敗,就重新確認狀態並重試,避免覆蓋其他執行緒已發布的更新。
Consolidation(整合)補充:把「底稿+修改紀錄」整理成新底稿;例如舊 Base Page 是 10、20、30,先新增 15、再刪除 20,整合後就成為新的 Base Page 10、15、30。
整合完成後,再用 CAS 將 Mapping Table 的入口改指向新的 Base Page;若入口在整合期間已改變,不能直接覆蓋,必須依協定處理。成功發布後,後續從新入口進入的查詢就不必走那串舊 Deltas;舊頁面與舊鏈則等到沒有讀者仍可能使用時,才安全回收。Consolidation 是同一邏輯頁面之內的版本整合,不是把兩個 B-Tree 節點合併,也不是 FD-Tree 的跨層 Run Merge。
這套節點更新機制支援 Latch-Free 操作,但 Delta Chains 的讀取、整合與記憶體回收仍有成本,也不表示單靠 CAS 就解決完整交易的隔離與持久化。參考 Microsoft Research:The Bw-Tree。
先分清楚 Node 與 Delta Chain:一個邏輯 Node 的目前內容,是由 Base Page 加上 Delta Chain 的修改共同決定的,不是只看 Base Page。**Delta Chain 太長 → Consolidation;Node 的有效資料太多 → Split;Node 的有效資料太少 → 考慮 Merge。**例如反覆修改同一筆資料,鏈可以很長,但有效資料仍只有一筆;持續新增不同 Key,才可能讓節點內容超過容量門檻。兩種門檻分別判斷,不要求一定先完成一次獨立的 Consolidation 才能 Split。
SMO(結構修改):先維持可達,再更新父節點
SMO 是 Structural Modification Operation,處理節點太大或太空時的 Split/Merge;Consolidation 整理同一個節點,SMO 則改變節點之間的結構。Bw-Tree 不能用一次 CAS 完成整個結構修改,因此把它分成其他執行緒能辨識、仍可安全導航的步驟。
原論文怎麼設定門檻?:2013 年 Bw-Tree 論文的 Section IV-A 說明,執行緒發現頁面大小超過系統門檻時,會在嘗試本次操作後執行 Split;Section IV-B 則說,節點大小低於某個門檻時會觸發 Merge。這兩節沒有指定通用的固定上限、下限或最低填滿比例;實驗設定中的預設 Page Size 為 8 KiB,也不能直接當成文中已明訂的一組 Split/Merge 門檻。Delta Chain 長度的 Consolidation 門檻另行設定。參考 Bw-Tree 原論文:Sections III-B、IV-A、IV-B 與 VI-A。
上下門檻怎麼設?:為了說明,可以假設本例每節點最多容納 5 筆,超過 5 筆就考慮 Split;少於 2 筆就考慮 Merge,且左右合併後不能超過 5 筆。此時右頁只剩 1 筆,低於合併門檻,而左頁 2 筆加右頁 1 筆共 3 筆、放得下,就符合本例的合併條件。這組「上限 5、低於 2 考慮合併」是教學假設,不是 Bw-Tree 的固定規格;實作可以依有效資料的位元組大小、項目數或占用比例設定上下門檻,也不一定要求像教科書 B-Tree 那樣維持固定的最低填滿比例。Delta Chain 長度則是另一個門檻,主要影響 Consolidation,不能與有效資料量混為一談。
Split:先讓搜尋能繞到新右頁。
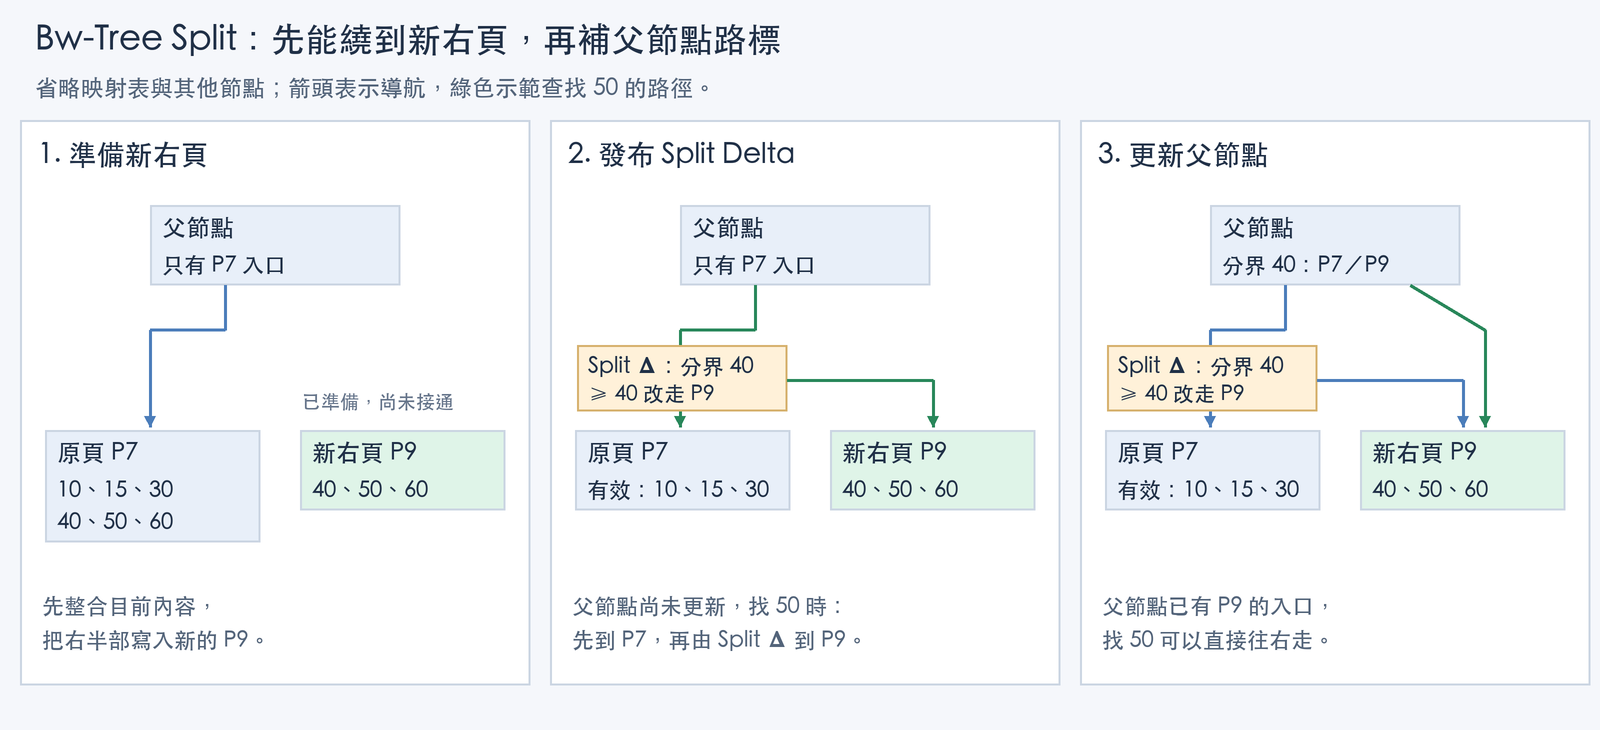
- 準備右頁:原頁 P7 有
10、15、30、40、50、60,先整理 Base 與 Deltas 的邏輯內容,再用右半部40、50、60建立新的 Base Page,作為新右側邏輯頁面 P9 的初始內容。P9 是邏輯頁面 ID,不是 Base Page 這種物件的名稱;剛建立時它的映射入口可直接指向這份 Base,後續更新仍能在前端接上自己的 Delta Chain。因此可以說右半部已整理成 Base,但不是把 P7 整條鏈原封不動變成 P9,也不必假設先完成一次獨立的 Consolidation 再開始 Split。 - 發布 Split Delta:在 P7 的入口安裝分界 40 與通往 P9 的連結;父節點雖仍只有 P7 入口,搜尋 50 可以先到 P7,再沿 Split Delta 到 P9,因此不會因父節點尚未更新就找不到資料。P7 的邏輯有效範圍改為小於 40,不代表舊鏈中對應的位元組已立即移除。
- 補上父節點入口:父節點加入分界與 P9 的導航項目,之後搜尋 50 就能直接走向 P9,省去繞路。
Split 時,Delta Chain 放哪裡?:不必把舊鏈逐筆拆成左右兩條。以上述分界 40 為例,P9 的新 Base 已包含右半部有效資料 40、50、60,剛建立時可以沒有更新 Delta;P7 則在原入口前接上 Split Delta,後面仍接原有的 Delta Chain 與舊 Base。Split Delta 宣告 P7 現在只負責小於 40 的範圍,40 以上改走 P9,因此舊鏈即使還留有右半部的紀錄,也不再作為 P7 的有效內容。之後 P7 做 Consolidation 時,才整理成只含左半部的新 Base;後續左右節點各自新增修改,也各自累積自己的 Delta Chain。
Merge:先接好合併後的內容,再撤掉舊入口。
Merge 的前提:假設左頁原本有 10、15、20、25,右頁有 30、35、40;後來刪除 20、25、35、40,有效資料就剩左頁 10、15(2 筆)、右頁 30(1 筆)。頁面不會因為刪除資料就自動合體,所以會出現偏空的相鄰節點。
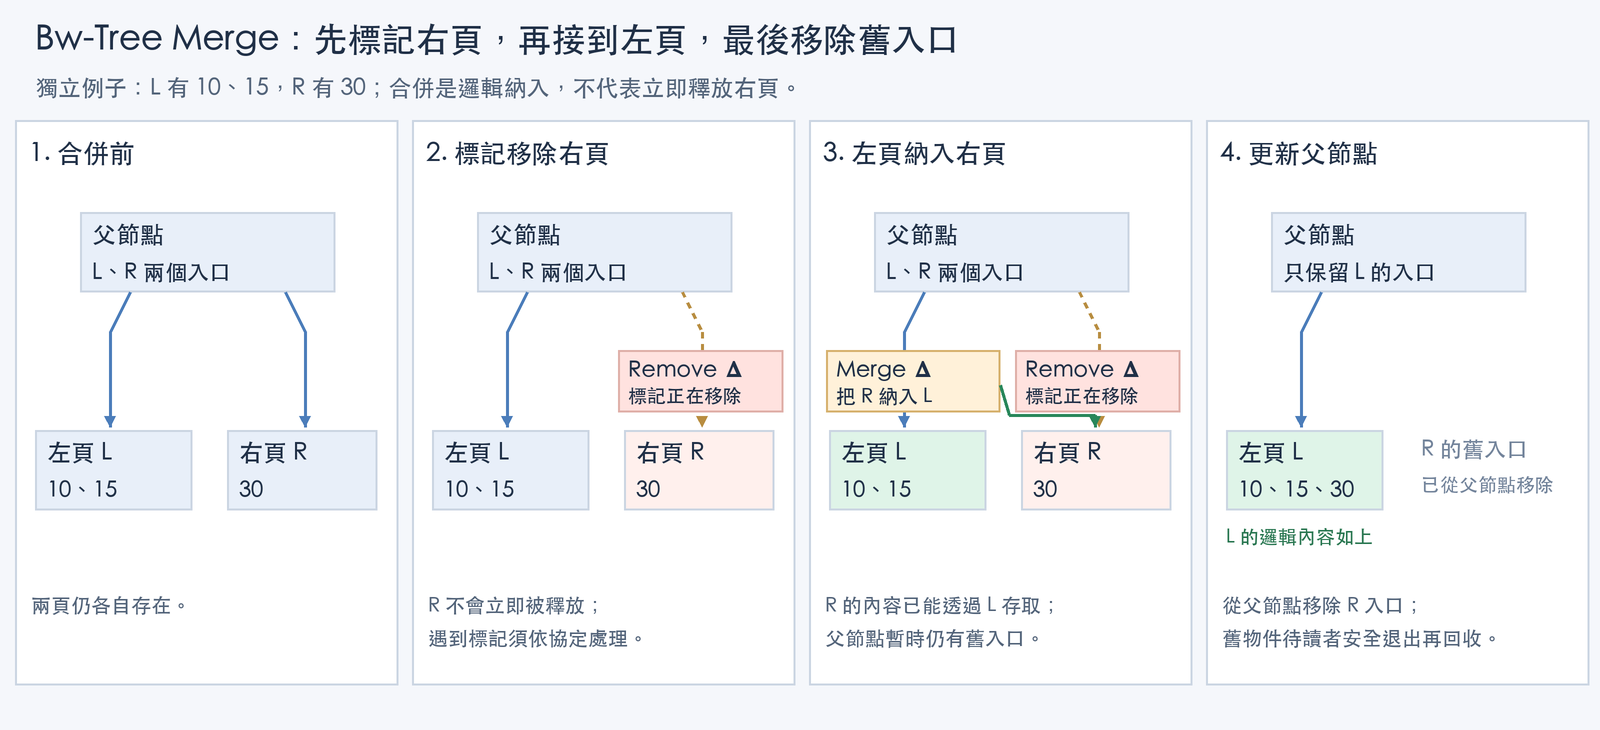
- 標記右頁:左頁 L 有
10、15,右頁 R 有30;先在 R 發布 Remove Delta,表示它正在移除,不是立刻釋放其記憶體。 - 左頁納入右頁:在 L 發布 Merge Delta,讓 R 的內容成為 L 的邏輯內容;此時未必已複製成一份連續的新 Base Page。
- 移除父節點舊入口:確認內容已能經由 L 存取後,再從父節點移除 R 的入口;L 的邏輯內容就是
10、15、30,舊頁與鏈仍須等安全回收條件成立才釋放。
圖中僅示意 Split/Merge 的流程;Bw-Tree 已發布的 Base Page 與 Delta Records 是不可變的,更新透過建立新版本並以 CAS 切換 Mapping Table 入口來發布,未完成的結構修改可由其他執行緒協助完成。參考 Bw-Tree 原論文。
Cache-Oblivious B-Tree:vEB Layout 與 Packed Array
前面的變種主要調整更新方式,這裡則改問:節點怎麼排列,才能減少搜尋時的資料搬移? Cache-Oblivious 不是不使用快取,而是設計時不必先知道 Cache Line、區塊大小或快取容量,仍透過資料排列改善區域性;它在模型中的傳輸成本保證,也不代表在所有真實硬體上都一定比較快。
一般 B-Tree 怎麼放?
以常見的磁碟 B+ Tree 為例,一個節點通常對應一個 Page,頁內放多個 Key 與指標,一次讀取就能取得多個搜尋線索。但父子頁不保證相鄰:Root 可以在 Page 3,孩子卻在 Page 8、Page 27;樹上相連,不代表檔案位置連續。vEB Layout 則進一步安排不同節點之間的存放順序,讓相關子樹占據連續區域。
| 設計 | 思考方式 |
|---|---|
| Cache-Aware | 知道區塊大小,據此調整節點大小或資料配置。 |
| Cache-Oblivious | 不把區塊大小當作演算法參數,透過遞迴配置,在不同尺度維持區域性。 |
vEB Layout 與 Packed Array:搜尋區域性與插入空間
書中把兩者搭配使用:**上方搜尋索引採用 vEB Layout,讓相關節點靠近,改善 Locality(區域性);底層有序資料使用 Packed Array,預留空位,讓插入不必每次都搬動大量元素。**索引負責定位底層資料,資料重新分配後,索引也要配合更新。
這裡的「切開」只是沿樹的高度分組,方便安排存放順序;父子關係不變,也不是 B-Tree 的 Split。 vEB 是 van Emde Boas 的縮寫,這裡討論的是 Layout,不必先學同名的整數搜尋樹。
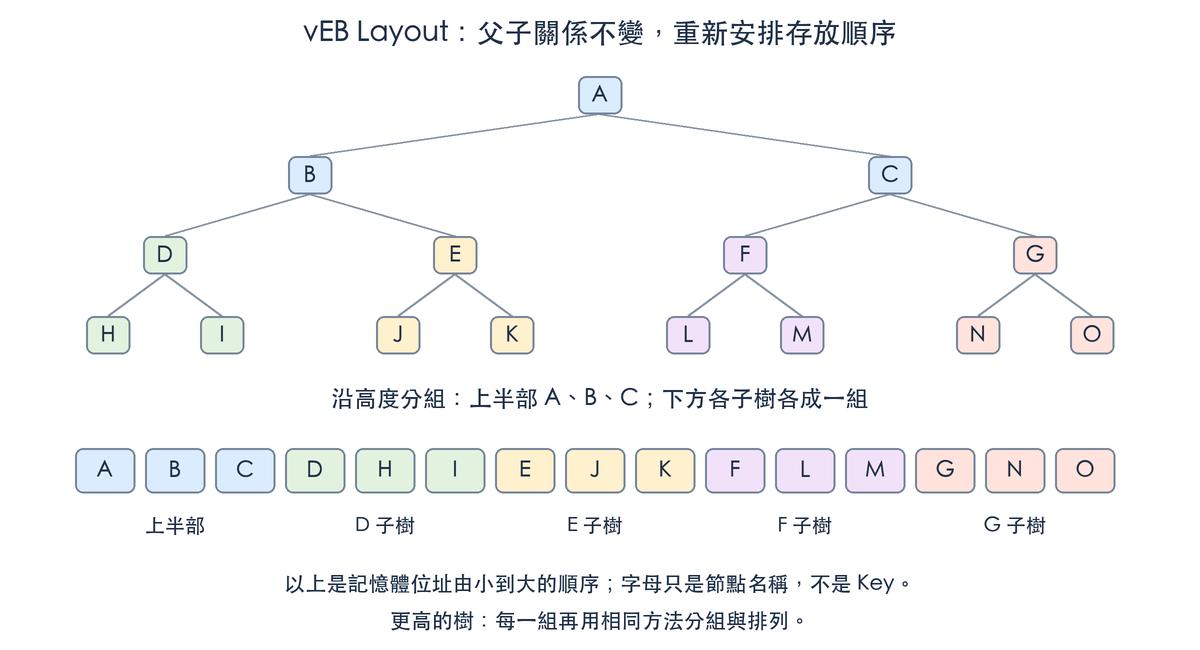
- 沿高度分成上下兩半:圖中四層樹的上半部是
A、B、C,下半部則形成四棵小樹:D、H、I、E、J、K、F、L、M、G、N、O。 - 先存上半部,再依序存下方子樹:得到圖下方的連續順序;例如
D、H、I會放在一起。字母只是節點名稱,不代表 Key 大小。 - 每組再用相同方法排列:樹更高時,每棵小樹再沿高度分組,直到只剩單一節點。這就是「遞迴排列」。
例如搜尋路徑 A → B → D → I,讀取 D 所在區塊時,鄰近的 I 可能一起載入。遞迴配置讓小子樹與大子樹都各自連續,因此不同大小的區塊都有機會涵蓋相關節點,而不必先指定區塊大小。這不保證每一步都命中快取。
有了搜尋索引的排列方式,接著還要處理底層資料的新增與刪除。Packed Array 把資料依 Key 排序放在陣列中,並預留空位;例如下表插入 15,就能直接使用 10 和 20 之間的空位。這些間隙是底層資料的插入空間,不代表在圖中的 A、B、C 索引節點之間固定塞入空格。
| 狀態 | 位置 1 | 位置 2 | 位置 3 | 位置 4 | 位置 5 |
|---|---|---|---|---|---|
| 插入前 | 10 | 空 | 20 | 空 | 30 |
| 插入 15 後 | 10 | 15 | 20 | 空 | 30 |
這次插入不用搬動其他資料;若附近沒有空位,仍要在更大範圍重新分配資料與空格。結構依不同範圍的密度門檻決定何時重分配,必要時擴大或縮小陣列;元素移動後,搜尋索引也須配合更新。空位不必固定間隔,也不是越多越好;過多空位會降低每個區塊能容納的有效資料量。兩者搭配的重點是:**vEB 改善搜尋路徑的區域性,Packed Array 則在保留有序資料區域性的同時,用適量空位降低插入的搬動成本。**參考 Cache-Oblivious B-Trees 原論文。
都有 vEB Layout,為什麼還需要 LSM-Tree?
**資料放得近,不等於不同 Key 的更新都能連續寫出。例如先後更新 10、5000、900000,vEB 可以改善各自搜尋路徑的區域性,但三筆更新仍可能落在相距很遠的區域。LSM-Tree 則先累積更新,再排序、批次寫出新的 Sorted Runs,降低逐筆修改分散位置的成本;代價是後續合併,以及查詢可能需要考慮多個 Runs。這裡的連續指檔案/區塊的順序存取,不保證 SSD 底層實體位置連續。
| 機制 | 主要處理的成本 |
|---|---|
| vEB Layout | 搜尋時跨區塊的資料搬移。 |
| Packed Array 的間隙 | 插入有序資料時的大量搬動。 |
| LSM-Tree 的批次寫入 | 大量小筆、分散更新的寫入成本;另須負擔合併工作。 |
vEB 主要安排「資料住哪裡」,LSM 還安排「更新何時一起寫出去」;兩者不能只因為都有連續配置,就視為可以互相取代。參考 LSM-Tree 原論文。